Kort forklart
Vektor-embeddings er en måte å gjøre tekst, bilder, produkter eller brukerinteresser om til tall som et datasystem kan sammenligne. Det gjør det mulig å finne ut hva som ligner på hva.
Dette er ikke bare teori. Spotify bruker tilsvarende representasjoner for anbefalinger. Meta bruker brukerhistorikk i annonseranking. Netflix forsker på anbefalinger og brukerinnsikt. Den samme grunnideen kan også brukes i en liten bedrift: for eksempel til å sortere kundehenvendelser, finne riktig prosedyre eller sende en sak til riktig person.
Det finnes allerede verktøy som kan gjøre deler av dette uten at dere bygger en stor AI-plattform selv. Men det betyr ikke at alle bør starte med Jev, OpenAI Decisions eller en vektordatabase. For mange er et godt regelsett, et vanlig AI-verktøy eller en enkel e-postflyt nok.
Hovedpoenget: Start med arbeidsoppgaven. Velg deretter den enkleste teknologien som løser den på en trygg og målbar måte.
Les mer: Jev – strukturerte beslutninger, Jev Decision Index, OpenAI Decisions, AI-routing og Offline AI.
Hva er et vektor-embedding?
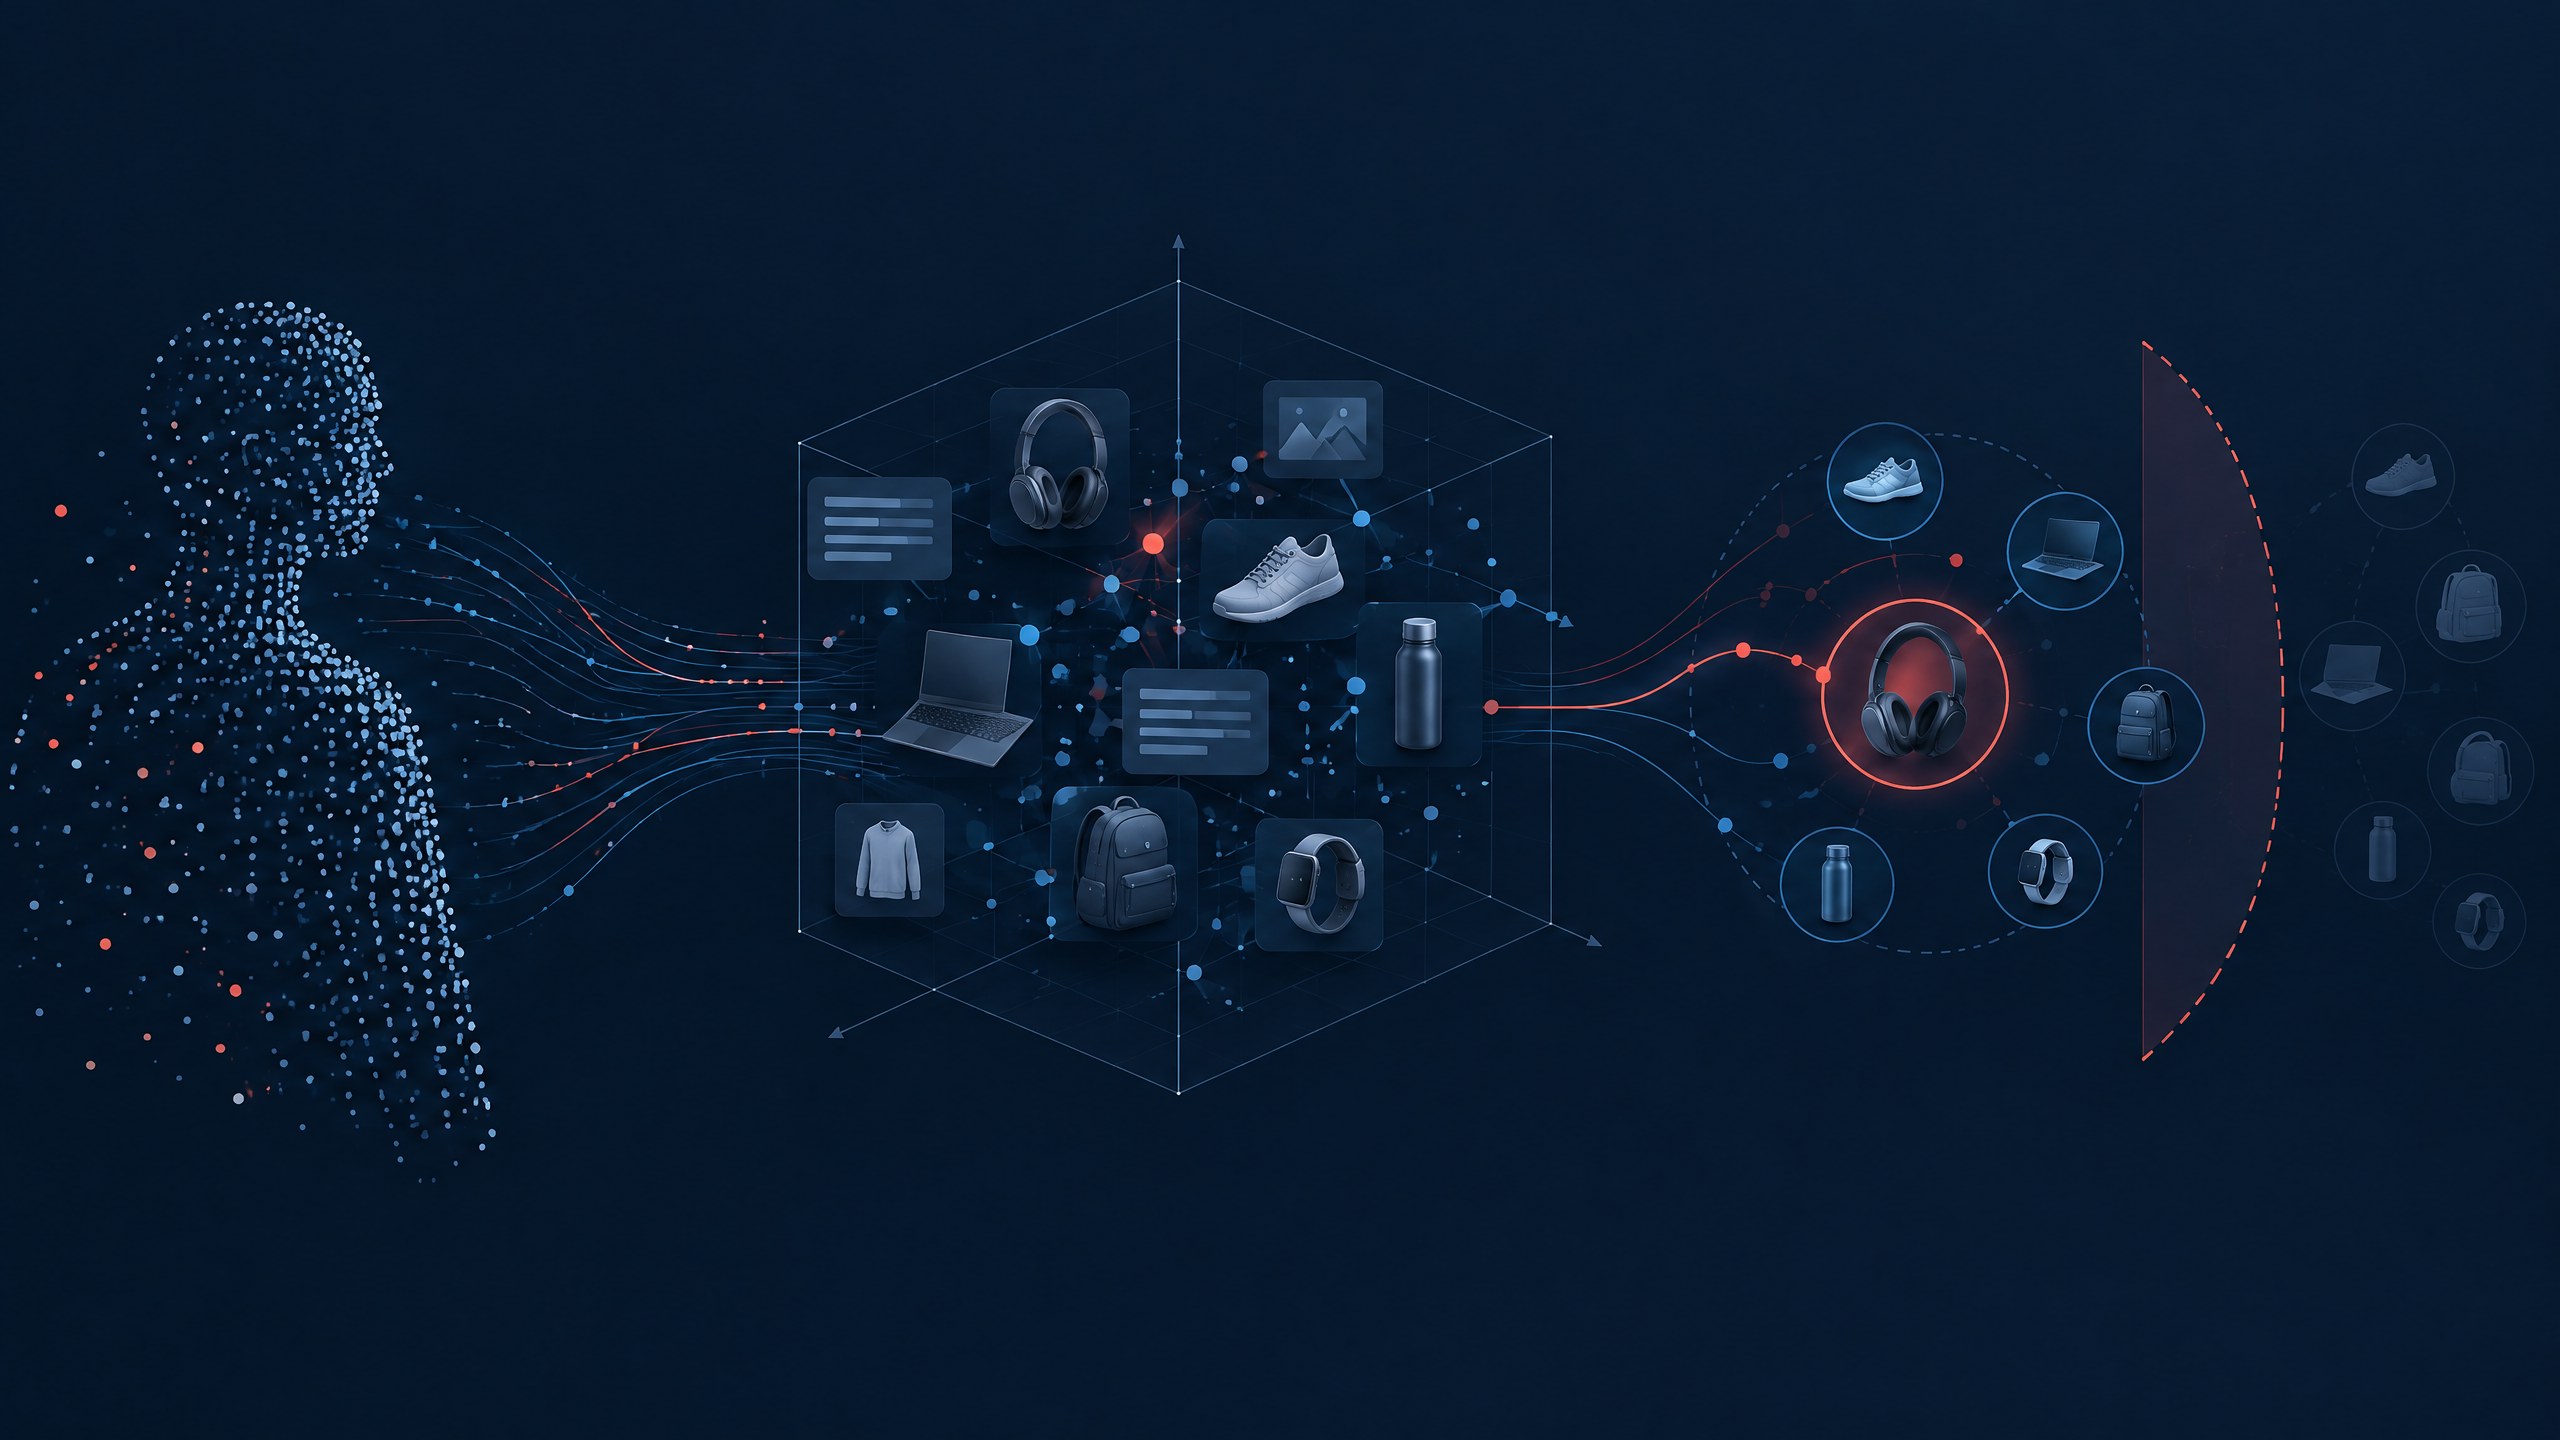
Et embedding er en representasjon av innhold som en liste med tall. Du kan tenke på det som et punkt i et stort matematisk kart.
En e-post om «feil på varmepumpe» kan havne nær en tidligere sak om «service på varmepumpe», selv om ordene ikke er helt like. En artikkel om sensorer i oppdrett kan havne nær en artikkel om overvåking av vannkvalitet. Systemet leter ikke bare etter samme ord. Det forsøker å finne likhet i betydning og mønster.
I en virkelig løsning er vektoren mye større enn eksemplene under. For å forklare prinsippet kan vi likevel tenke slik:
```text E-post A: «Vi trenger hjelp med fakturaen» E-post B: «Hvor finner jeg kopi av regningen?»
De bruker forskjellige ord, men kan ligge nær hverandre fordi begge handler om faktura og betaling. ```
OpenAI beskriver embeddings som nyttige for semantisk søk, gruppering, anbefalinger, avviksdeteksjon og klassifisering. [1]
Hva betyr klassifisering?
Klassifisering betyr at systemet velger en kategori for noe.
En kundehenvendelse kan for eksempel klassifiseres som:
- salg
- support
- faktura
- booking
- reklamasjon
- viktig og må behandles raskt
- uklart og må vurderes av en person
Det kan gjøres på flere måter. Et enkelt system bruker regler, som at e-poster med ordet «faktura» sendes til økonomi. Et mer avansert system bruker embeddings for å finne lignende saker. En beslutningsmodell kan svare på et tydelig spørsmål, for eksempel «Hvilken kø skal denne saken til?». En språkmodell kan til slutt skrive et sammendrag eller et svarutkast.
Dette kan oppsummeres i en enkel arbeidsflyt:
```text E-post, klikk, kjøp eller dokument ↓ Embedding ↓ Finn lignende innhold ↓ Jev / OpenAI Decisions velger eller scorer ↓ Regler og terskel ↓ Menneske eller AI ```
Embeddings finner likhet. Beslutningsverktøy velger eller scorer. Regler og menneskelig kontroll avgjør hva som faktisk får skje.
Dette er forskjellige oppgaver. Derfor er det nyttig å skille mellom å finne noe som ligner, å velge en kategori og å skrive tekst.
Et enklere første steg: semantisk søk i egne dokumenter
Profilering er bare én bruk. For mange bedrifter er semantisk søk et bedre og tryggere sted å begynne.
En medarbeider kan skrive:
«Kunden mener fakturaen er feil. Hva er rutinen?»
Det interne dokumentet kan ha tittelen:
«Behandling av innsigelser mot fakturagrunnlag»
Et vanlig søk kan bomme fordi ordene er forskjellige. Embeddings kan finne at innholdet handler om det samme, og hente frem riktig rutine. Det samme kan brukes på servicehistorikk, produktbeskrivelser, HMS-dokumenter eller interne spørsmål og svar.
Dette trenger ikke å være en annonseprofil. Dere kan bruke embeddings på bedriftens egne dokumenter, med begrenset tilgang og en tydelig sletterutine.
Hvordan kan en profil bygges opp?
På en stor plattform kan mange små signaler kombineres til en representasjon av en bruker. Dette kan være hva personen søker etter, klikker på, ser ferdig, hopper over, kjøper eller kommer tilbake til.
For å gjøre prinsippet forståelig viser tabellen under en oppdiktet eksempelprofil. Tallene fra 0,00 til 0,99 er ikke faktiske data fra Spotify, Meta eller Netflix. De viser bare hvordan et system kan bruke styrkegrader i stedet for faste merkelapper.
| Mulig interesse eller egenskap | Eksempelperson A | Hva kan ha påvirket estimatet? |
|---|---|---|
| Voksent innhold | 0,12 | Har raskt valgt bort eller forlatt lignende innhold |
| Politikk | 0,68 | Har lest flere analyser og klikket på nyhetsbrev om valg |
| Pop | 0,84 | Har spilt pop, lagret artister og fullført spillelister |
| Rock | 0,31 | Har hørt på enkelte låter, men ofte hoppet videre |
| Thriller | 0,77 | Har sett flere thrillere ferdig og søkt etter lignende titler |
| Tilbud og pris | 0,91 | Har sammenlignet priser og brukt rabattkoder |
| Kvalitet eller premium | 0,73 | Har lest tester og valgt dyrere alternativer |
En virkelig modell har ikke nødvendigvis en kolonne som heter «politikk» eller «kvalitet». Det kan være mange hundre eller tusen dimensjoner som mennesker ikke kan tolke direkte. Tabellen er derfor en pedagogisk oversettelse.
Et høyt tall betyr heller ikke at personen faktisk har en bestemt egenskap. Det betyr at modellen har funnet et mønster som kan være nyttig for å prioritere innhold. Sensitive kategorier kan være feil eller urimelige slutninger. De bør ikke brukes ukritisk i beslutninger om mennesker.
Når du sammenlignes med andre brukere
Anbefalingssystemer kan også se etter brukere som har gjort noe som ligner. Dette kalles ofte collaborative filtering.
Tenk på tre personer:
| Person | Det systemet ser | En mulig, men skjult kobling |
|---|---|---|
| A | Kjøper en arbeidslampe, leser om lokal AI og klikker på en CRM-annonse | Ligner på en gruppe som ofte kjøper programvare for kundeservice |
| B | Kjøper samme arbeidslampe, leser om oppdrett og klikker på en annen annonse | Har noen av de samme kjøps- og klikkmønstrene som A |
| C | Leser om økonomi, ser en video om automatisering og kjøper en annen vare | Får senere anbefalt innhold som også traff A og B |
For en person kan arbeidslampen, artikkelen og annonsen være helt separate ting. For modellen kan kombinasjonen ligne på mønsteret til en større gruppe. Systemet kan derfor teste en anbefaling uten at sammenhengen er åpenbar for oss.
Det betyr ikke at modellen har forstått årsaken. Den har funnet en statistisk likhet. Korrelasjon er ikke det samme som at en person har en bestemt egenskap eller kommer til å kjøpe noe.
Spotify, Meta og Netflix bruker samme grunnidé
Spotify: smak over tid
Spotify forklarer selv at anbefalinger påvirkes av søk, lytting, hopping, lagring, hvem du følger, språk, enhet og eventuelt posisjon. Spotify kaller dette blant annet en «smaksprofil». [2]
I en teknisk artikkel beskriver Spotify et system der hver lytter får en høydimensjonal representasjon i et stabilt vektorrom. Systemet bruker signaler fra flere tidshorisonter, blant annet omtrent seks måneder, én måned og én uke. Det gjør det mulig å kombinere varig smak med nye interesser. [3]
Spotify rapporterer egne produksjonsresultater fra dette arbeidet, blant annet 2,9 prosent økning i oppdagelse av innhold, 13 prosent økning i overgangen fra anbefalt innhold til avspilling, 0,76 prosent økning i suksess for podkastsøk og 0,20 prosent forbedring i musikkoppdagelse. Dette er Spotifys egne tester på egne systemer. Det er ikke en garanti for samme effekt andre steder. [3]
Meta: historikk pluss ferske signaler
Meta beskriver en flerstegsmodell for annonseranking. Et system behandler lange brukerhistorikker offline og lager representasjoner som kan lagres på brukernivå. Et annet system jobber raskere og kombinerer representasjonen med ferske signaler fra den konkrete annonsen. [4]
Meta rapporterer et kumulativt løft på 6 prosent i konverteringer på Instagram, 3 prosent på Facebook og 3,5 prosent i Facebook-annonseklikk for den samlede modellutviklingen. Dette er leverandørens egne målinger på egen trafikk og infrastruktur. En liten norsk bedrift bør derfor se dette som et eksempel på mulig systemlogikk, ikke som et løfte om samme resultat. [4]
Netflix: anbefalinger, men ikke alle detaljer er offentlige
Netflix Research oppgir anbefalinger, innholdsverdi, strømming og brukerinnsikt som forskningsområder. [5] Det er rimelig å bruke Netflix som et eksempel på avanserte anbefalingssystemer.
Netflix publiserer imidlertid ikke alle detaljer om den interne produksjonsarkitekturen. Derfor bør vi være forsiktige med å si at Netflix bruker en bestemt vektordatabase eller én bestemt modell i alle deler av tjenesten. En ekstern forklaring kan gjøre vektorprinsippet forståelig, men må ikke omtales som full dokumentasjon av Netflix sine interne systemer.
Hva bør en liten bedrift bruke?
Du trenger ikke starte med den mest avanserte løsningen. Velg ut fra hva du faktisk skal gjøre.
| Behov | Start her | Når noe mer avansert kan passe |
|---|---|---|
| Få e-poster til riktig person | Regler og faste kategorier | Når formuleringene varierer mye og reglene blir vanskelige å vedlikeholde |
| Finne riktig dokument eller rutine | Semantisk søk med embeddings | Når dere har mange dokumenter og vanlig søk ikke finner riktig innhold |
| Velge mellom salg, support og økonomi | Strukturert klassifisering | Når dere trenger score, sannsynlighet eller tydelige stoppregler |
| Vurdere tekst og bilder etter faste kriterier | OpenAI Decisions eller tilsvarende beslutningsverktøy | Når beslutningen må ta hensyn til flere typer innhold |
| Skrive svar, sammendrag eller forklaring | Claude, ChatGPT eller annen språkmodell | Når modellen skal formulere tekst etter at kategori og kilder er bestemt |
| Utføre handlinger på tvers av systemer | Godkjent integrasjon eller agent | Først når tilgang, logging og menneskelig godkjenning er på plass |
Et praktisk valg kan oppsummeres slik:
- Få saker og tydelige kategorier: Start med regler.
- Mange dokumenter og vanskelig søk: Vurder embeddings.
- Fast valg eller score: Vurder Jev.
- Tekst eller bilder etter bestemte kriterier: Vurder OpenAI Decisions.
- Svar, sammendrag og forklaring: Bruk Claude, ChatGPT eller en annen språkmodell.
- Handlinger i flere systemer: Vurder en agent først når tilgang, logging og menneskelig godkjenning er på plass.
Når passer Jev?
Jev er interessant når oppgaven kan formuleres som et avgrenset valg eller en score. For eksempel:
«Skal denne henvendelsen til support, økonomi eller salg?»
«Hvor godt passer denne saken til kategorien reklamasjon?»
Jev returnerer strukturerte beslutninger som valg, score eller sannsynligheter, i stedet for et langt tekstsvar. Det kan gjøre det egnet som et raskt beslutningslag i en arbeidsflyt. Jev er likevel en early access/API-tjeneste. Det bør testes på egne eksempler før dere bygger en viktig prosess rundt det. Type-sikker output betyr heller ikke at beslutningen alltid er faglig riktig.
Når passer OpenAI Decisions?
OpenAI Decisions er relevant når dere allerede bruker OpenAI og vil stille et tydelig beslutningsspørsmål til tekst eller bilder. Resultatet kan være en predicate, choice eller score. [6]
Et eksempel kan være å vurdere om et bilde av en vare ser ut til å ha riktig emballasje, eller om en e-post skal sendes til en bestemt kø. Også her bør dere bruke faste kategorier, eksempler, terskler og menneskelig kontroll.
Når bør dere velge noe enklere?
Hvis dere bare har 20 e-poster i uken og tre tydelige kategorier, kan regler eller en vanlig AI-integrasjon være mer enn nok. Hvis medarbeideren uansett må lese alt, kan et enkelt sammendrag gi større gevinst enn en avansert klassifiseringsmodell.
Jev, OpenAI Decisions og embeddings er ikke automatisk bedre. De er nyttige når volumet, variasjonen eller kostnaden gjør en enklere løsning utilstrekkelig.
Et praktisk eksempel: klassifisering av e-post
Tenk deg en bedrift som mottar henvendelser om service, faktura, booking og nye oppdrag.
Dere trenger heller ikke bytte ut dagens systemer for å teste dette. Første løsning kan legges oppå Gmail eller Microsoft 365, CRM-et, helpdesken, et nettskjema eller dokumentene dere allerede har i SharePoint, Google Drive eller en intern mappe. Målet er å koble et lite søke- eller klassifiseringslag til arbeidsflyten dere allerede bruker.
1. Bestem kategoriene
Start med fire eller fem kategorier. Skriv også ned eksempler på hva som ikke passer i hver kategori. Legg til en kategori som heter «uklart – menneske må vurdere».
2. Koble til e-postsystemet dere allerede bruker
Dere trenger ikke flytte e-posten til en ny plattform. En integrasjon kan hente inn nye meldinger, klassifisere dem og skrive tilbake en etikett, oppgave eller intern kommentar. Tilgangen bør begrenses til det som trengs. Systemet bør ikke få lov til å sende, slette eller videresende e-post uten godkjenning.
3. Velg riktig beslutningslag
- Bruk regler hvis kategoriene er enkle.
- Bruk embeddings hvis dere først og fremst vil finne lignende saker eller rutiner.
- Bruk Jev hvis dere trenger et raskt, strukturert valg eller en score.
- Bruk OpenAI Decisions hvis tekst eller bilder skal vurderes etter definerte kriterier.
- Bruk Claude eller ChatGPT til sammendrag og svarutkast etter at kategori og kilder er kontrollert.
4. Send bare vanskelige saker videre
En enkel sak kan gå gjennom et raskt og rimelig beslutningslag. En sak med lav sikkerhet eller sensitive opplysninger kan stoppes og sendes til en medarbeider. Bare de sakene som trenger mer forklaring, kan sendes til en større språkmodell.
Denne typen routing kan være både raskere og mer kostnadseffektiv enn å sende hele innboksen gjennom den største modellen hver gang.
5. La et menneske godkjenne i starten
I pilotperioden bør systemet legge på en foreslått kategori, ikke flytte saken automatisk. Sammenlign forslaget med hva medarbeideren faktisk ville valgt. Først når dere kjenner feiltypene, kan dere vurdere mer automatisering.
Hvorfor dette også kan være bra for personvern
Vektor- og beslutningsverktøy er ikke automatisk personvernvennlige. Men de kan gjøre det mulig å bygge en mer kontrollert løsning enn å sende hele dokumentet, hele innboksen eller hele kundehistorikken gjennom en stor språkmodell hver gang.
Dere kan for eksempel:
- behandle dokumenter på en lokal eller intern server
- sende bare nødvendige tekstutdrag videre
- bruke en liten beslutningsmodell til første sortering
- holde sensitive saker tilbake fra eksterne tjenester
- slette mellomdata etter en fast periode
- logge hvilken kategori systemet foreslo og hvorfor
- kreve menneskelig godkjenning før en melding sendes
Et embedding er ikke anonymt bare fordi det er en liste med tall. Vektorer kan kobles til en bruker, inngå i en profil eller brukes til nye slutninger. Personvern handler derfor om hele løsningen: datagrunnlag, leverandør, lagring, tilgang, formål og sletting.
Før dere starter, bør dere vite:
- Hvilke opplysninger trenger systemet faktisk?
- Kan navn, fødselsnummer og andre identifikatorer fjernes først?
- Hvor behandles dataene, og hvor lenge lagres de?
- Hvem kan se resultatet og rådataene?
- Hva skjer når systemet er usikkert eller tar feil?
- Kan kunden eller medarbeideren få en forklaring og be om manuell vurdering?
Datatilsynet peker blant annet på formålsbestemthet, dataminimalisering, rettferdighet og gjennomsiktighet som viktige hensyn ved bruk av KI. [7]
En enkel vei videre
For de fleste bedrifter er dette en bedre start enn å kjøpe inn en stor AI-plattform:
- Velg én innboks, én dokumenttype eller én arbeidsflyt.
- Samle 50–100 eksempler og merk dem manuelt.
- Test først regler eller et vanlig AI-verktøy.
- Mål hvor ofte kategorien blir riktig, hvor mye tid som spares og hvilke feil som oppstår.
- Test embeddings, Jev eller OpenAI Decisions bare hvis den enklere løsningen ikke er god nok.
- Koble på e-post eller andre systemer med begrensede tilganger.
- Legg inn stoppregler og menneskelig godkjenning før dere automatiserer mer.
AI-routing-artikkelen viser hvordan ulike modeller kan få ulike roller. Jev-artikkelen går mer i dybden på beslutningsmodellen. Offline AI-artikkelen forklarer når lokal behandling kan være interessant.
Kilder
[1]: https://developers.openai.com/api/docs/guides/embeddings "OpenAI — Embeddings" [2]: https://www.spotify.com/no-nb/safetyandprivacy/understanding-recommendations "Spotify — Slik fungerer anbefalinger" [3]: https://research.atspotify.com/2025/9/generalized-user-representations-for-large-scale-recommendations "Spotify Research — Generalized user representations for large-scale recommendations" [4]: https://engineering.fb.com/2026/08/05/ml-applications/from-user-sequences-to-scaling-laws-a-multi-stage-architecture-for-metas-ads-ranking/ "Meta Engineering — From User Sequences to Scaling Laws" [5]: https://research.netflix.com/ "Netflix Research" [6]: https://developers.openai.com/api/docs/guides/decisions "OpenAI — Decisions" [7]: https://www.datatilsynet.no/regelverk-og-verktoy/rapporter-og-utredninger/kunstig-intelligens/ "Datatilsynet — Kunstig intelligens og personvern"