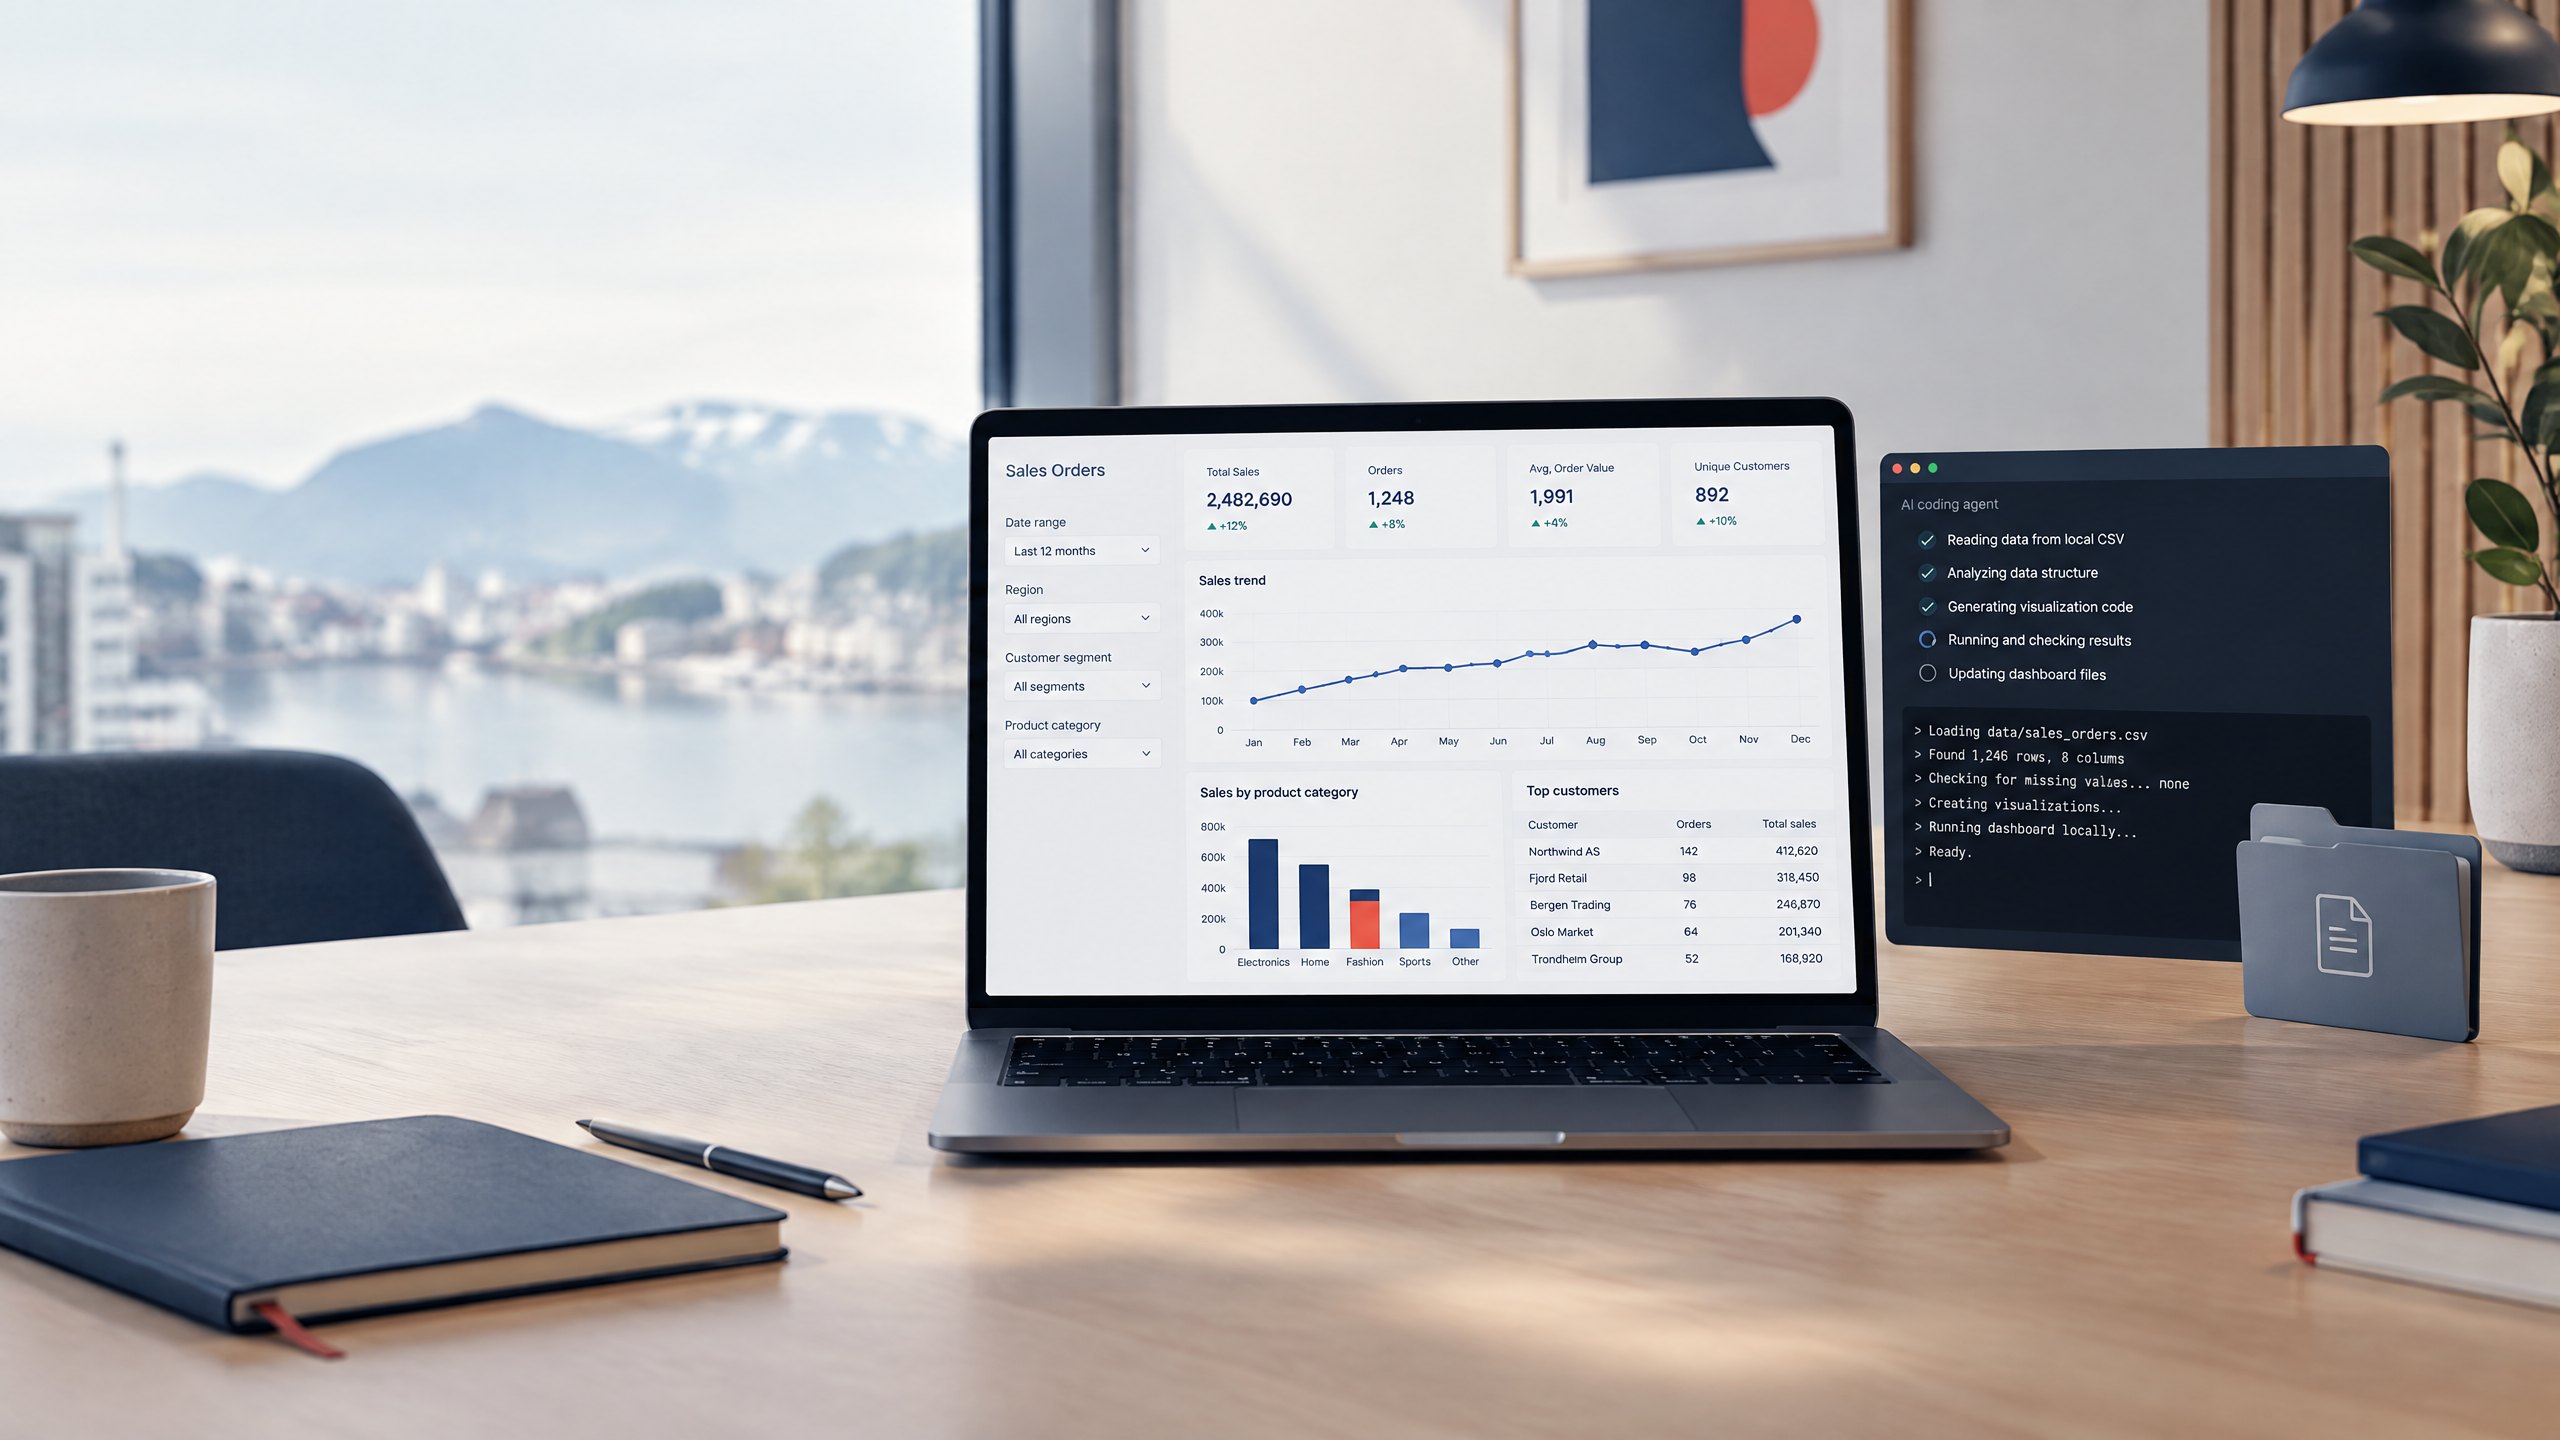
Det er lett å tro at et dashboard alltid krever en stor BI-plattform, en database og et utviklingsteam. OMP viser en annen inngang: Du kan gi en AI-agent et datasett, be den skrive dashboard-koden og få en lokal prototype som du kan åpne i nettleseren.
OMP er kortnavnet for Oh My Pi. Det er en coding agent med IDE-en koblet inn, bygget videre på Pi-rammeverket. Med andre ord er OMP ikke en språkmodell, men et arbeidsmiljø som lar en modell lese filer, skrive kode, kjøre kommandoer og arbeide i en prosjektmappe. [1] [2]
Det interessante for en liten bedrift er ikke at OMP kan skrive kode av seg selv. Det interessante er at terskelen for å gjøre et uoversiktlig datasett om til en første visning blir lavere.
Fra CSV til interaktivt dashboard
I en video fra Tiny får OMP en CSV-fil med ordredata. Agenten leser filen, rydder i datasettet, undersøker strukturen og skriver koden til et interaktivt dashboard. Resultatet viser blant annet nøkkeltall, utvikling over tid, produktkategorier og en tabell som kan filtreres og sorteres. [3]
Videoen oppgir at hele kjøringen tar omtrent fire minutter og 22 sekunder. Det er en demonstrasjon på et konkret datasett, ikke en garanti for at alle CSV-filer blir riktige på samme tid. Likevel viser den en arbeidsmåte som mange bedrifter kan kjenne igjen:
- Dere har et datasett som ligger ubrukt eller bare åpnes i Excel.
- OMP får lese en kopi av filen og beskrive kolonnene.
- Agenten lager en første versjon av dashboardet.
- Dere tester tallene mot en kjent fasit.
- Dashboardet justeres før det eventuelt brukes av flere.
Det kan være ordre, lagerbeholdning, timer, prosjektstatus, produksjonstall eller en anonymisert oversikt over henvendelser. Poenget er ikke å la AI-en bestemme hva tallene betyr. Poenget er å få en raskere første visning som mennesker kan kontrollere.
Hva er spesielt med OMP?
OMP er ikke en konkurrent til Claude, Qwen eller en annen språkmodell. Det er laget rundt modellen. Det som skiller OMP fra en vanlig chatklient eller en ren modellserver, er kombinasjonen av et terminalbasert agentmiljø, kodeverktøy, filtilgang, kjøring av programmer og modellruting i samme arbeidsflate. OMPs GitHub-prosjekt oppgir blant annet mange leverandørruter, flere roller for ulike typer arbeid, innebygde utviklerverktøy og støtte for lokale endepunkter. [2]
I praksis betyr det at du kan bruke én modell til vanlig arbeid, en mindre modell til enkle deloppgaver og en sterkere modell når oppgaven krever mer analyse. Du kan også peke OMP mot en lokal modell via Ollama, LM Studio, llama.cpp, vLLM eller LiteLLM. Det er denne kombinasjonen av agent + verktøy + routing + lokal modellstøtte som er interessant for interne datasett.
OMP erstatter likevel ikke Ollama eller LM Studio. De kan være laget for å laste inn og servere modellen lokalt. OMP er laget for å få en agent til å bruke modellen til å lese filer, skrive kode, kjøre tester og bygge en løsning. Du kan derfor bruke LM Studio eller Ollama som lokal modellserver, og OMP som arbeidsmiljøet over.
Tiiny-videoen og lokal AI
I denne artikkelen henviser vi til en konkret video fordi den viser arbeidsflyten i praksis. I Tiny AI-videoen om OMP og dashboard fra ordredata får OMP en CSV-fil, undersøker datasettet og lager et interaktivt dashboard med nøkkeltall, grafer og filtrering. Videoen bruker Tiny API som modelltilkobling. Den oppgir ikke en bestemt Qwen- eller Gemma-modell i selve demonstrasjonen, så det bør ikke fremstilles som en test av én bestemt modell.
Dette er forskjellen på demonstrasjonen og en helt lokal løsning: Her brukes et API for å gjøre oppsettet enkelt. Med en lokal Tiiny-enhet, Ollama, LM Studio, vLLM eller LiteLLM kan den samme typen arbeidsflyt kobles mot en modell som kjører i eget miljø. OMP er arbeidsverktøyet over modellen. Den lokale serveren eller enheten leverer selve modellresponsen.
For en nærmere forklaring av Tiiny som lokal USB-C-enhet, lokal API-tilkobling og bruk uten skyen, se Offline AI: Når bør AI kjøre lokalt — og når er skyen bedre?. Artikkelen forklarer også når lokal AI er fornuftig, og hva som må kontrolleres før man kaller en løsning «offline».
Eksempler på hvordan OMP kan brukes
OMP kan bruke ulike modeller til ulike oppgaver. En mindre modell kan lese kolonner og lage en enkel oppsummering. En større modell kan skrive mer omfattende kode, feilsøke eller planlegge en løsning. En synsmodell kan brukes når agenten skal tolke et bilde eller et diagram.
For lokal kjøring kan Qwen- eller Gemma-modeller være naturlige steder å starte. På en vanlig PC er en 7–14B-modell i 4-bit-kvantisering ofte mer realistisk enn en modell på 70B eller 120B. I Tiiny sin egen modellbutikk nevnes blant annet Qwen3.8-27B, Qwen3.6-35B-A3B, GPT-OSS-120B og Gemma. Det er modeller som er tilpasset eller validert for Tiiny-plattformen, og kravene kan derfor ikke overføres direkte til en vanlig laptop. [5]
OMP-videoen: hvilke funksjoner er interessante?
Den andre videoen som omtales her er Better Stacks gjennomgang av Oh My Pi. Den handler ikke om CSV-dashboardet, men viser hvorfor OMP kan være mer enn en enkel terminal-chat. Den omtaler OMP som et agentisk harness bygget på Pi, med et mer utviklerorientert arbeidsmiljø.
LSP-integrasjon: I stedet for bare å lese tekstfiler kan OMP bruke Language Server Protocol til oppgaver som å endre navn på en modul eller refaktorere en funksjon på tvers av mange filer. Videoen viser dette som en workspace-orientert arbeidsmåte, mer lik funksjonene du forventer fra en IDE. [4]
Debugger-støtte: Videoen viser også støtte for Debug Adapter Protocol. Det kan koble agenten til en debugger som debugpy eller Delve, slik at den kan undersøke stoppunkter, stack frames og tilstanden i et program. Dette er mest relevant for utviklere som jobber med reelle kodebaser, ikke for et enkelt CSV-dashboard. [4]
Hash-baserte linjeendringer: OMP kan målrette endringer mot innholdshasher i stedet for å sende hele gamle og nye tekstblokker. Videoen fremhever at dette kan redusere unødvendige token og risikoen for at whitespace eller store diff-er skaper feil. Påstanden om opptil 61 prosent lavere tokenbruk gjelder demonstrasjonen med Grok 4 Fast. Det bør derfor leses som et eksempel fra videoen, ikke som en generell besparelse for alle modeller. [4]
Modellruting og roller: OMP kan bruke ulike modeller til ulike oppgaver, for eksempel en synsmodell for bilder eller en annen modell for planlegging og dypere analyse. Modellen er fortsatt avgjørende for kvaliteten, men OMP gjør det enklere å organisere hvilke modeller som skal brukes når.
Videoen nevner også nettleserverktøy, PDF-lesing, subagenter, pull request-gjennomgang, pakker fra Pi-økosystemet og Hindsight for agentminne. Dette er nyttig når OMP skal brukes som et utviklingsmiljø over tid. Det betyr samtidig mer tilgang og flere bevegelige deler. Bruk derfor separate prosjektmapper, begrens verktøytilgang og krev at agenten viser hva den har gjort før endringer tas i bruk.
Hvor mye RAM trenger OMP og modellen?
OMP selv er ikke den store minneposten. Det er språkmodellen, konteksten, verktøyene og eventuelle parallelle oppgaver som bestemmer behovet. En grov tommelfingerregel for en 4-bit kvantisert modell er omtrent 0,5–0,7 GB minne per milliard parametere for selve modellvektene. I tillegg kommer operativsystem, OMP, runtime, kontekst/KV-cache og arbeidsfiler. Derfor må du ha mer minne enn filstørrelsen på modellen alene tilsier.
| Maskin | Fornuftig startpunkt | Kommentar |
|---|---|---|
| 8 GB RAM, ingen dedikert GPU | 1–3B | 7B kan starte CPU-only, men blir ofte treg og bør ha kort kontekst. |
| 16 GB RAM, 4–8 GB VRAM | 7–8B Q4 | Et realistisk minimum for lokal agenttesting og mindre dashboardoppgaver. |
| 32 GB RAM, 12–16 GB VRAM | 14B Q4 | Mer komfortabelt for koding og analyse; 20–24B kan kreve delvis CPU-kjøring. |
| 64 GB RAM, 20–24 GB VRAM | 20–32B Q4 | Mulig for tyngre oppgaver, men hastigheten avhenger av modell og kontekst. |
| 96–128 GB RAM eller 48 GB+ VRAM | 70B Q4 | Aktuelt for større modeller, men normalt mer enn du trenger for et lokalt dashboard. |
Det finnes ikke en universell minimumsgrense. En modell med lang kontekst kan bruke mer minne enn en mindre modell med kort kontekst. Flere samtidige forespørsler øker også behovet. Ollama viser dette tydelig ved at modellen kan ligge helt i GPU, helt i systemminnet eller fordeles mellom CPU og GPU. [7]
Som utgangspunkt anbefaler LM Studio minst 16 GB RAM og minst 4 GB dedikert VRAM på Windows. Det betyr ikke at alle modeller passer, men det er et greit nivå for å komme i gang med mindre lokale modeller. På en Mac med Apple Silicon anbefaler LM Studio 16 GB eller mer, mens 8 GB kan fungere med små modeller og moderat kontekst. [6]
For OMP og dashboardarbeid ville jeg startet enklere enn mange modelltabeller på nettet antyder: 16 GB RAM og en nyere CPU er nok til å teste. Har maskinen 8 GB VRAM, kan en 7–8B Q4-modell være et praktisk førstevalg. Har du 32 GB RAM og 16–24 GB VRAM, får du langt mer arbeidsrom. Du trenger ikke en 70B-modell for å lese en CSV, lage et diagram eller skrive en lokal HTML-prototype.
Tallene over er planleggingsregler, ikke ytelsesgarantier. Test med den faktiske modellen, ønsket kontekstlengde og den arbeidsflyten du skal bruke.
Er dette egentlig offline?
Her er det viktig å skille mellom tre ulike ting:
- Lokalt datasett: CSV-filen ligger på egen maskin eller server.
- Lokalt dashboard: Den ferdige nettsiden eller applikasjonen kan åpnes uten internett.
- Lokal AI-modell: Modellen som skriver koden kjører også på egen maskin eller i eget nettverk.
I Tiny-videoen brukes en API-nøkkel til Tiny API og en modell via denne tjenesten. Det betyr at demonstrasjonen viser et lokalt arbeidsresultat, men ikke en komplett offline-kjede. Datasettet eller deler av arbeidsflyten kan gå til en skytjeneste under genereringen. [3]
Hvis dere faktisk skal holde dataene offline, må både datasettet og modellen være lokale. OMP oppgir støtte for lokale ruter mot blant annet Ollama, LM Studio, llama.cpp, vLLM og LiteLLM. Det gjør det mulig å koble agenten til en modell som kjører på en lokal PC eller intern server, men dere må sette opp og kontrollere denne infrastrukturen selv. [2]
Det er også mulig å bruke en hybridmodell. En ufølsom eksempeldatafil kan sendes til en skytjeneste for å lage en prototype, mens reelle kunde-, HR- eller økonomidata bare brukes mot en godkjent lokal modell. Den regelen må håndheves teknisk. Det holder ikke å skrive «ikke send data ut» i prompten.
En prompt du kan starte med
En første oppgave kan se slik ut:
Les `data/ordre.csv` og beskriv kolonnene før du skriver kode. Lag et lokalt dashboard som kan kjøres uten database og uten nettverk etter oppstart. Vis omsetning per måned, antall ordre per kundegruppe, topp fem produkter og en tabell med filtrering på dato og region. Kontroller summer mot rådata. Dokumenter manglende verdier, antakelser og hvilke tester som er kjørt. Ikke send filen til en ekstern tjeneste.
Dette er en god start, men det er ikke en sikkerhetsgaranti. Agenten kan misforstå en kolonne, tolke datoer feil eller lage en beregning som ser riktig ut uten å være det. Derfor bør den første versjonen behandles som en prototype.
Slik kontrollerer du resultatet
Før dashboardet brukes i et møte eller i en beslutning, bør noen kontrollere fire ting:
Datagrunnlaget: Er alle kolonnene forstått riktig? Er det duplikater, manglende verdier eller datoer i feil format?
Beregningene: Stemmer totalsum, antall ordre og gjennomsnitt med en manuell kontroll eller en eksisterende rapport?
Filtrene: Gir dashboardet riktig svar når dere velger en bestemt måned, kundegruppe eller region?
Tilgangen: Kan uvedkommende åpne filene eller dashboardet? Ligger det rådata i nettleserens kildekode eller i en mappe med for vide rettigheter?
Dette er særlig viktig for økonomi og HR. Et lokalt dashboard kan redusere dataflyten, men «lokalt» betyr ikke automatisk sikkert. Maskinen trenger fortsatt oppdateringer, passord, backup, logging og en plan for hvem som har tilgang.
OMP er ikke en ferdig BI-plattform
OMP er et verktøy for å få en agent til å arbeide med kode og filer. Det er ikke det samme som Power BI, Metabase eller et ferdig rapporteringssystem. Det finnes ingen automatisk garanti for datakvalitet, universell tilgangsstyring eller at dashboardet tåler produksjonsbruk.
Fordelen er fleksibilitet. Agenten kan lage en liten løsning som passer akkurat til datasettet deres. Dere kan be om en statisk HTML-side, et lite Python-dashboard eller en enkel applikasjon som kjører på en intern server. Ulempen er at dere selv må eie koden, modellvalget, testene og driften.
For en bedrift som allerede har mange ulike modeller, kan OMP også inngå i en større AI-routing-strategi. En lokal modell kan håndtere data som ikke skal ut av virksomheten, mens en godkjent skymodell kan brukes på ufølsomme oppgaver. Når agenten får lese filer og kjøre kommandoer, blir et tydelig harness viktig: avgrens tilgangen, krev kontroll av resultatet og stopp før en risikabel handling.
Når passer dette for en liten bedrift?
OMP kan være interessant når dere har et konkret datasett og et spørsmål dere vil undersøke. «Hva solgte vi per måned?» eller «Hvor blir lageret stående?» er bedre startpunkter enn «lag et system for all virksomhetsstyring».
Begynn med en kopi eller anonymisert versjon av dataene. Be agenten først forklare hva den har forstått. Lag deretter et dashboard med tre til fem visninger. Sammenlign resultatet med dagens rapport. Hvis det sparer tid og tallene er etterprøvbare, kan dere vurdere en mer robust intern løsning.
Dette passer godt sammen med Offline AI: Når bør AI kjøre lokalt — og når er skyen bedre?. OMP kan gjøre byggingen raskere, men dere må fortsatt bestemme hvilke oppgaver som skal kjøres lokalt, hva som kan sendes til skyen og hvem som har ansvaret når tallene brukes.
Kort oppsummert
OMP gjør det enklere å gå fra «vi har en CSV» til «vi har en første interaktiv visning». Det kan gi små bedrifter en rask vei til å undersøke ordre-, lager- og prosjektdata uten å starte med en stor plattform.
Den viktigste forskjellen går mellom dashboardet som kjører lokalt og hele arbeidsflyten som er offline. Skal ingen data ut, må også modellen, runtime og nettverksreglene være lokale. Og uansett modell må tallene kontrolleres før de brukes som beslutningsgrunnlag.
Kilder
[1] OMP — coding agent with the IDE wired in [2] GitHub — can1357/oh-my-pi [3] Tiny AI — OMP lager et interaktivt dashboard fra ordredata [4] Better Stack — Oh My Pi: AI agent harness walkthrough [5] Tiiny AI Pocket — lokal enhet, modeller og API-er [6] LM Studio — System Requirements [7] Ollama — FAQ om minne, GPU/CPU og kontekst