Denne artikkelen hører sammen med Jev: AI som velger, scorer og ruter. Les gjerne den først hvis du vil forstå hva Typesafe Jev er og hvilke typer arbeidsflyter en beslutningsmodell kan passe i.
Jev Decision Index er en fellesskapsdrevet oversikt på Hugging Face over åpne prosjekter som prøver å gjenskape eller nærme seg ideen bak Typesafe Jev: AI som gir raske, strukturerte vurderinger i stedet for lange tekster.
Dette er relevant fordi det gir et mer nøkternt bilde enn en enkelt demo eller en markedsføringspåstand. Men det må også leses riktig: Indeksen er ikke en offisiell test fra Typesafe, og den dokumenterer ikke at noen har gjenskapt den kommersielle Jev-modellen eller dens påståtte kalibrering. Den viser hvordan åpne eksperimenter presterer på en bestemt, frossen testpakke.
Først: hva er Jev, og hva er Decision Index?
Den offisielle Jev-artikkelen forklarer Typesafes modell som en System One-modell. I stedet for å skrive fritekst token for token, tar Jev inn en tilstand og et sett med tydelige spørsmål. Den returnerer strukturerte valg, skårer eller sannsynligheter som programvare kan bruke direkte.
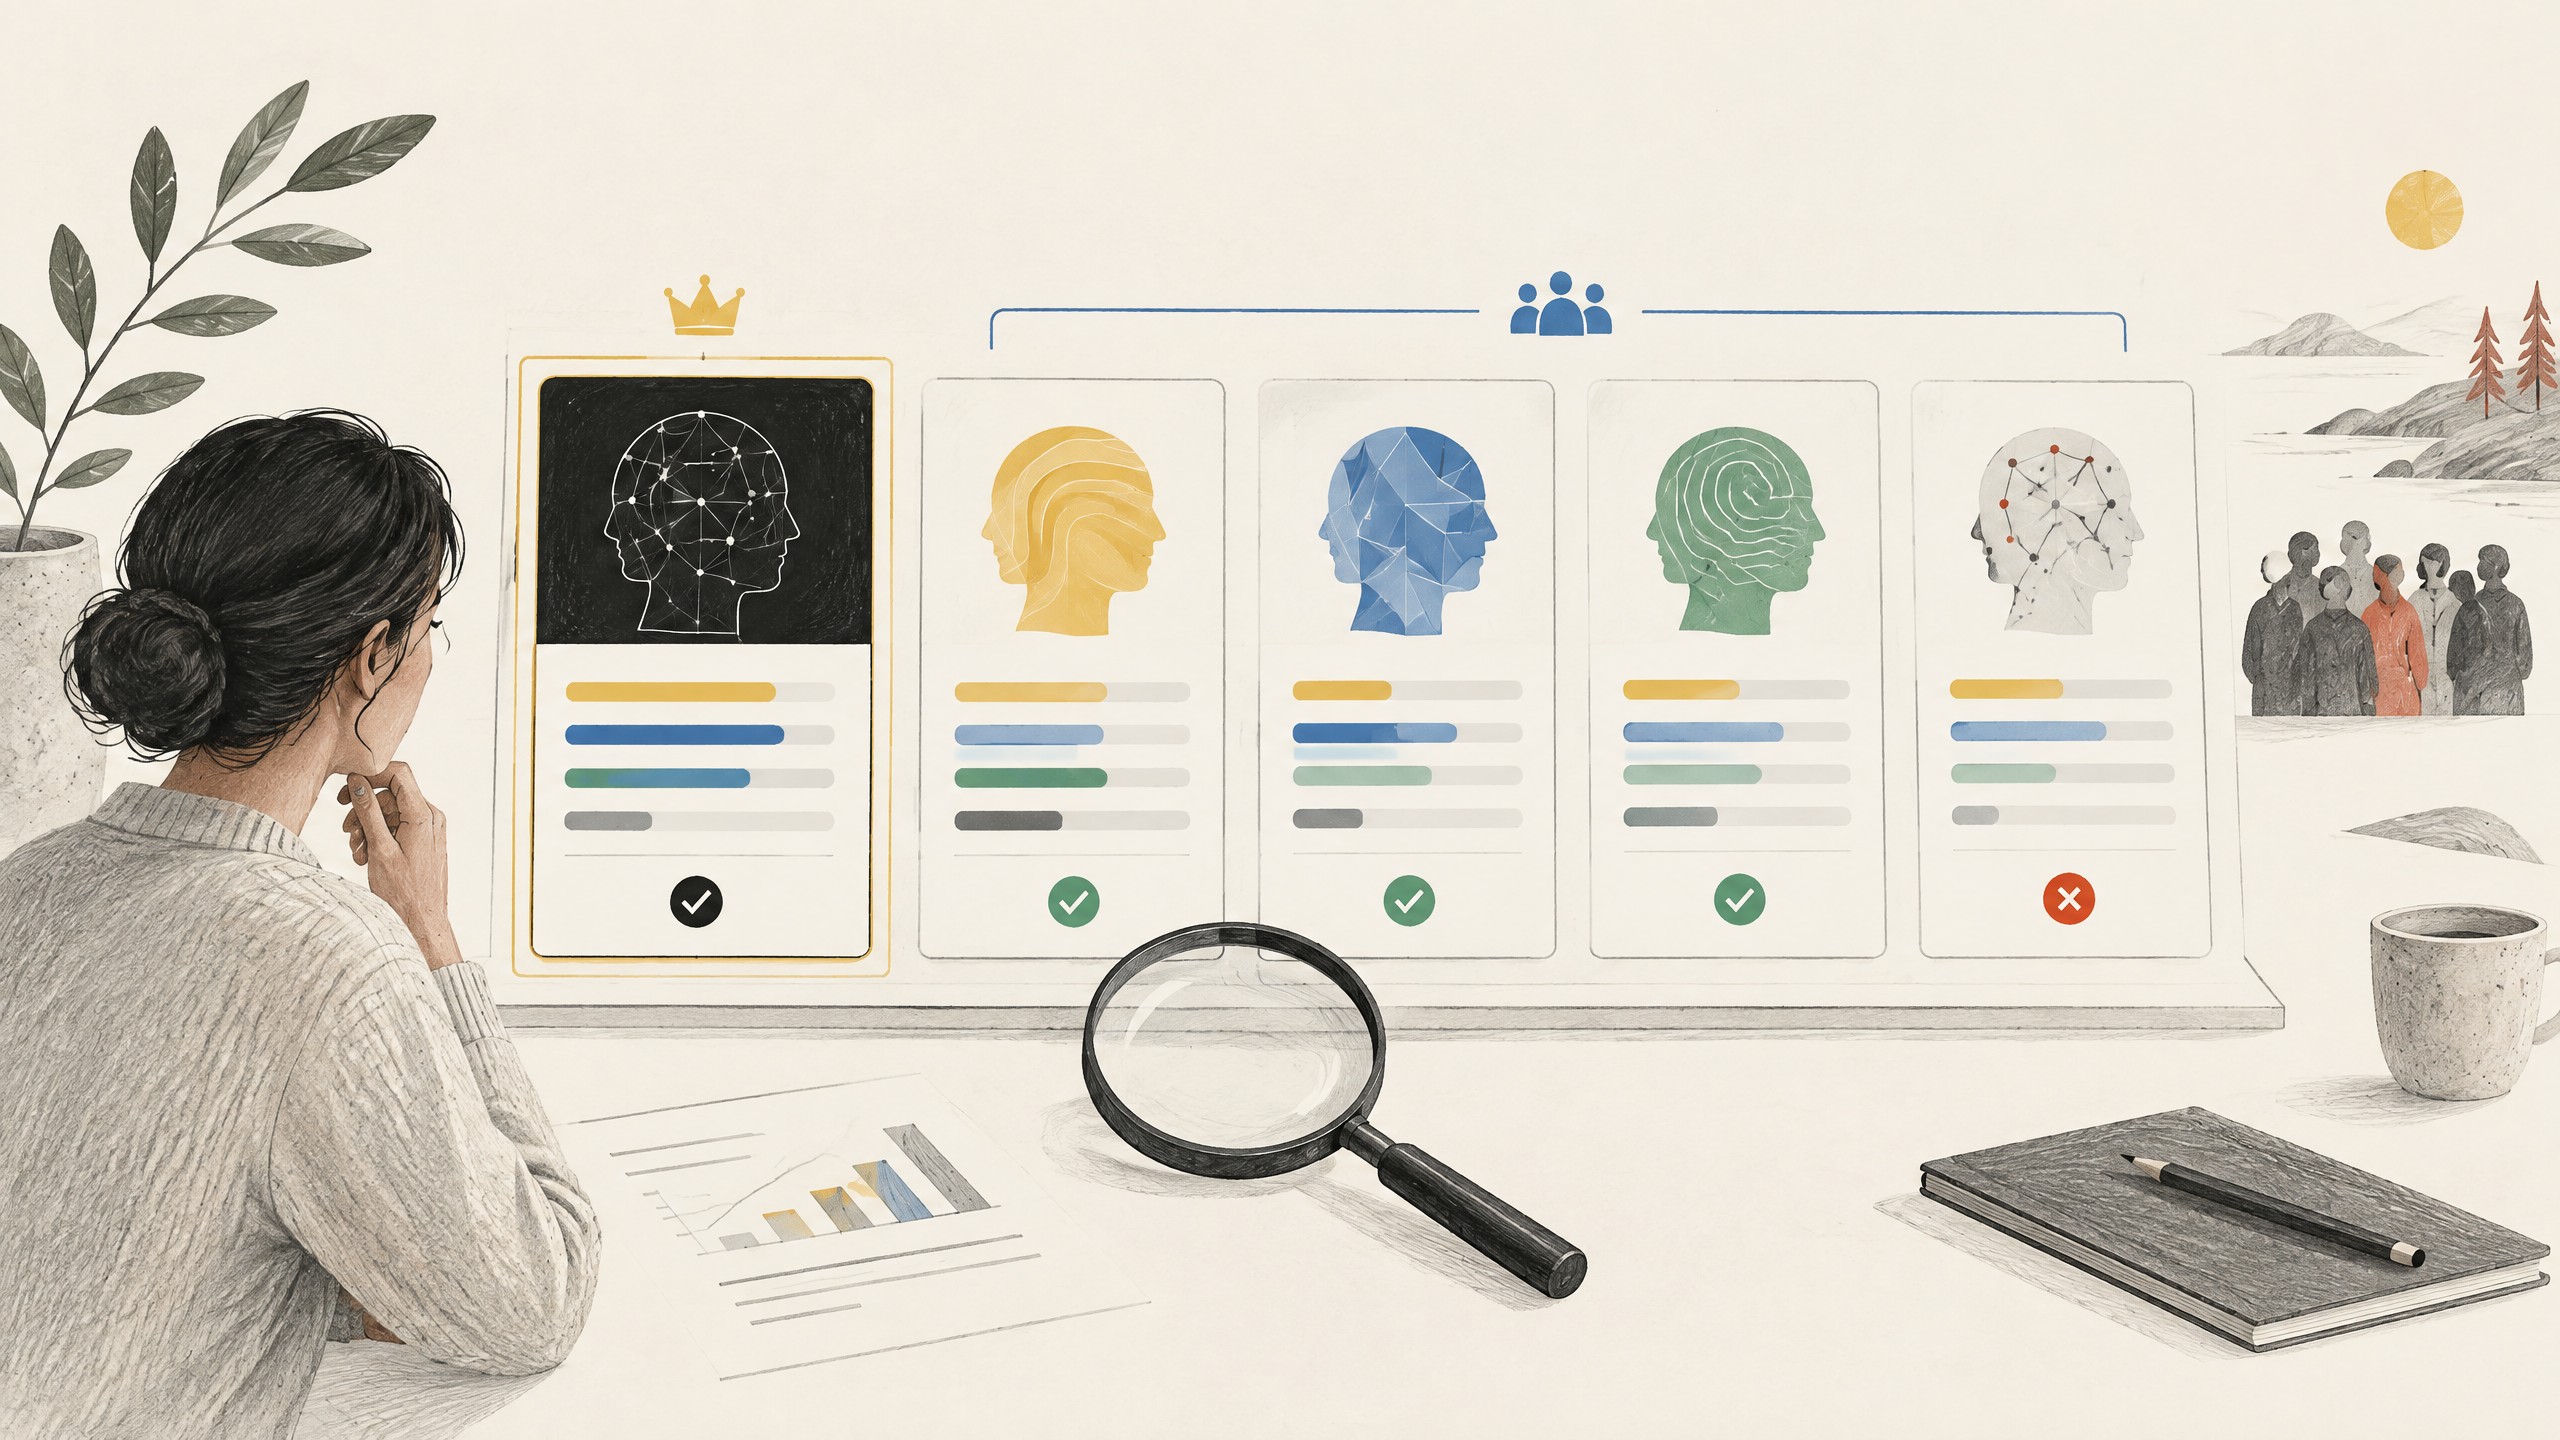
Jev Decision Index er noe annet. Det er en offentlig tracker for åpne reproduksjoner og beslektede prosjekter. Den samler modeller og teknikker som forsøker å løse lignende oppgaver, og viser resultater i en felles leaderboard.
Space-en skiller blant annet mellom:
- modeller med nye, trente vekter eller beslutningshoder
- tilpasninger og finetuning av eksisterende modeller
- rene dekodingsteknikker som kjører på vanlige modeller uten nye vekter
- diffusion-baserte forsøk
- forklaringer, benchmarks og «dette finnes allerede»-påstander
Det er nyttig, fordi disse metodene ikke er det samme. Et nytt beslutningshode, en promptteknikk og en komplett modellarkitektur kan se like ut i en overskrift, men ha helt ulike krav til trening, maskinvare, stabilitet og drift.
Hva måler indeksen?
Decision Index samler resultater fra en felles testsuite og setter dem sammen til en oversiktlig skår med delresultater. Ifølge prosjektets README brukes flere områder, blant annet kunnskap og resonnering, språkforståelse, uthenting og klassifisering. Ulike utgaver av indeksen har brukt ulike paneler og beregningsmåter.
Den nåværende statiske siden beskriver både offentlig testmateriale, private tester av de samme ferdighetene og private oppgaver fra nye domener. Målet er å gjøre det vanskeligere å overtilpasse seg én åpen benchmark.
Dette er en styrke, men ikke en fasit. En felles indeks gjør sammenligning enklere. Den forteller ikke automatisk:
- om modellen forstår deres fagområde
- om resultatet er godt nok på norsk
- om sannsynlighet og confidence faktisk er godt kalibrert i deres situasjon
- om svartid og kostnad passer i deres løsning
- om modellen tåler mangelfulle eller rotete data
- om den er trygg å koble til systemene deres
En god benchmark kan være en start på utvelgelsen. Den er ikke slutten på testarbeidet.
Hvorfor dette er interessant etter Jev-lanseringen
Da Typesafe lanserte Jev, ble ideen om små, raske og strukturerte beslutninger løftet frem som et alternativ til å bruke en stor språkmodell til alt. Decision Index gjør det lettere å se hvor mange ulike veier åpen kildekode-miljøet prøver ut rundt samme problem.
Det betyr ikke at alle prosjekter i indeksen er produksjonsklare. Enkelte er tidlige eksperimenter, noen er lovede modeller, og andre er teknikker som bruker en eksisterende modell på en annen måte. Les derfor modellkort, lisens, datagrunnlag og målemetode før dere lar én score styre et teknologivalg.
Dette er også en påminnelse om at «AI-modell» ikke er én kategori. Noen modeller er laget for samtale. Andre for koding, prognoser, bildeanalyse eller avgrensede beslutninger. TimesFM 3 er for eksempel interessant for tidsserier, mens Jev-lignende modeller er interessante når systemet trenger et tydelig valg eller en skår.
Et praktisk eksempel: sortering av kundehenvendelser
Tenk at en bedrift får inn e-post, nettskjema og meldinger gjennom flere kanaler. En språkmodell kan oppsummere innholdet og lage et høflig svarutkast. Men systemet trenger kanskje også noen raske, konkrete beslutninger:
- Hører henvendelsen til salg, service eller faktura?
- Er det nok informasjon til å opprette sak?
- Bør saken behandles raskt?
- Skal den sendes til en fagperson, eller be om mer informasjon?
Dette er typen avgrensede spørsmål som kan passe for strukturerte skårer og valg. Men dere må selv definere hva som er riktig, hva som skal skje når modellen er usikker, og hvem som kan overprøve resultatet.
En god pilot kan derfor starte med forslag og sortering, ikke automatisk endring i CRM, pris, kundeløfter eller prioritering av mennesker. Se også artikkelen om AI-orkestrering for hvordan modeller og kontrollpunkter kan få ulike roller i samme arbeidsflyt.
Hva bør dere teste selv?
Hvis dere vurderer en beslutningsmodell eller en åpen Jev-reproduksjon, lag et eget testsett før dere kobler modellen til reelle systemer. Testsettet bør inneholde vanlige saker, vanskelige grensetilfeller og eksempler der systemet må si «usikker» eller sende saken til et menneske.
Mål minst tre ting:
| Hva dere måler | Hvorfor det er viktig |
|---|---|
| Treff på riktig valg | En høy gjennomsnittsskår hjelper lite hvis viktige saker rutes feil. |
| Usikkerhet og dekning | Modellen må kunne stoppe eller eskalere når grunnlaget er svakt. |
| Konsekvens av feil | En feil i en intern sorteringsliste er noe annet enn en feil i pris, personell eller regnskap. |
Dette ligner på prinsippene i Loop Engineering: mål resultatet, kontroller feilene og forbedre arbeidsflyten før dere øker friheten til agenten.
Laya er ett konkret, åpent spor
Laya er et av prosjektene som Decision Index samler i den åpne delen av landskapet. Det er en separat, Apache 2.0-lisensiert beslutningsmodell med choice-, score- og noul-oppgaver. Laya-MLX er en uavhengig MLX-port som kan kjøre Laya lokalt på Apple Silicon. Den viser hvorfor indeksen må leses med omtanke: Her sammenlignes både modeller, finetunede beslutningshoder, dekodingsteknikker og runtime-varianter – ikke bare like produkter.
Laya-MLX er interessant for en lokal pilot fordi den bruker mindre modeller enn en generell LLM og er laget for strukturerte svar. Men den er fortsatt teknisk programvare som krever lokal modellhåndtering, passende checkpoint, kontroll av språk og testing på egne data. Den er ikke en offisiell Jev-versjon og bør ikke tolkes som en direkte erstatning for Typesafes tjeneste. Les mer om den praktiske forskjellen i Jev-artikkelens Laya-del.
Hva har finetuning med dette å gjøre?
Noen av prosjektene i Decision Index er merket som trente eller finetunede. Det betyr at utviklerne har tilpasset en eksisterende modell eller trent et ekstra beslutningslag for en bestemt type oppgave.
Det er ikke i seg selv bedre enn en generell modell eller en god prompt. Det kommer an på dataene, testene og oppgaven. Finetuning-artikkelen forklarer forskjellen mellom å lære en modell en stabil arbeidsmåte, gi den oppdatert kunnskap i en kunnskapsbase og bare forbedre instruksjonene.
Konklusjon: bruk indeksen som kart, ikke som fasit
Jev Decision Index er interessant fordi den gjør en ny og litt uklar modellkategori mer synlig. Den viser at mange miljøer undersøker hvordan AI kan gi strukturerte valg, skårer og sannsynligheter uten å måtte være en stor chatmodell hver gang.
For norske bedrifter er lærdommen enkel: Se på slike indekser for å finne kandidater og forstå utviklingen. Men test alltid på egne oppgaver, egne språk og egne feilkonsekvenser. En modell som er god på en offentlig benchmark, har ikke automatisk rett til å ta beslutninger i deres kundesystem, økonomi eller personalarbeid.