Mye av AI-en vi bruker i dag skjer i skyen. Du skriver en oppgave i Claude, ChatGPT eller et annet verktøy, og teksten, bildet eller dokumentet behandles på leverandørens infrastruktur. Offline AI — ofte kalt lokal eller on-device AI — betyr at modellen kjører på en PC, en lokal server eller en egen boks hos deg, uten at selve forespørselen må sendes til en ekstern AI-tjeneste.
Det høres enkelt ut: Hold dataene hjemme, spar tokenkostnader og fortsett selv når nettet er borte. Men valget er mer nyansert. Lokal AI krever fortsatt maskinvare, oppdateringer, strøm, backup, tilgangsstyring og noen som eier driften. Sky-AI kan på sin side gi tilgang til mer avanserte modeller, fersk informasjon og enklere samarbeid — men krever at dere forstår databehandleravtale, rettigheter og hva som faktisk deles.
Det riktige spørsmålet er ikke «lokalt eller i skyen?». Det er «hvilken oppgave, hvilke data og hvilket ansvar skal denne AI-en ha?»
Hva er offline AI godt for?
Lokal AI er særlig interessant når oppgaven er avgrenset, gjentar seg ofte og kan løses med en modell som er liten nok til maskinen dere eier. Det kan være å transkribere interne møter, gjøre første sortering av dokumenter, søke i eget arkiv, lage utkast basert på godkjente maler eller hjelpe et team med tekst, kode og analyse uten stabil internettforbindelse.
Det betyr ikke at all informasjon automatisk blir privat bare fordi maskinen står på kontoret. Datatilsynet peker på blant annet formålsbestemthet, dataminimalisering, gjennomsiktighet og informasjon som sentrale personvernspørsmål ved bruk av KI. [1] En lokal løsning må derfor fortsatt ha riktige brukere, riktige rettigheter, oppdaterte komponenter, gode logger og kontroll på hvilke filer som hentes inn i systemet.
Tiiny AI: Et tegn på at lokal AI blir mindre og mer tilgjengelig
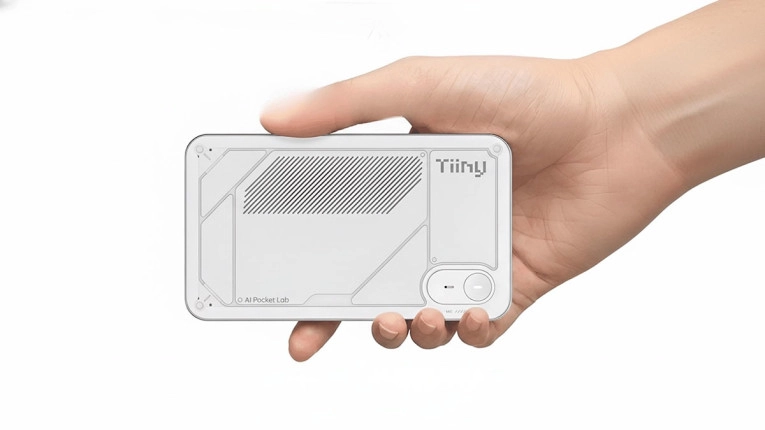
Tiiny AI Pocket Lab er et eksempel på den nye maskinvarekategorien. Kampanjen beskriver en liten datamaskin for lokale, åpne språkmodeller og agenter, med OpenAI API-kompatibilitet og påstand om støtte for modeller på opptil 120 milliarder parametere. [2] Det er spennende fordi terskelen mellom «egen AI-server» og en liten boks på skrivebordet blir lavere.
Kakushin har Tiiny AI i bruk
Tiiny har publisert en benchmark: Hva kan en liten lokal AI-motor faktisk gjøre?
Tiiny har nå publisert en benchmarkrapport for Tiiny Pocket. Den viser hvor raskt en lokal modell kan svare når AI-en kjører på en liten enhet hos deg, uten å sende selve oppgaven til store servere på nettet. Rapporten tester Qwen3.5-9B-Turbo på Tiiny Pocket 01. [15]
I den kortere kodetesten målte Tiiny 50,1 tokens per sekund. Tokens er små biter av tekst som modellen lager underveis. Det tilsvarer grovt rundt 35–40 ord i sekundet i vanlig tekst, eller over 2 000 ord i minuttet. Tallet er likevel ikke en generell skrivehastighet: Det gjelder én bestemt modell, én bestemt maskin og en bestemt test. Det sier heller ikke hvor raskt AI-en leser og forstår et stort dokument.
Når modellen må ha mye tekst tilgjengelig samtidig, går hastigheten ned. Tiiny målte 33,1 tokens per sekund ved 64K kontekst og 29,8 ved 128K kontekst. Det betyr at store filer kan ta mer tid og bruke mer minne. Derfor er det ofte bedre å hente inn de relevante delene av et arkiv enn å sende inn alt på én gang.
Hva betyr dette for en vanlig bedrift? Det betyr at lokal AI kan være rask nok til å inngå i reelle arbeidsflyter. Du kan for eksempel kjøre en lokal modell til kode, tekstutkast, dokumentsøk, transkribering, bildegenerering eller musikk — uten aktiv internettforbindelse mens oppgaven kjører. Modellene må normalt lastes ned først, og kvaliteten varierer fra modell til modell.
Et konkret eksempel er OMP: Slik lager du et offline dashboard fra egne datasett. OMP er ikke selve språkmodellen, men et arbeidsmiljø som kan lese en CSV-fil, skrive dashboard-kode, kjøre kommandoer og lage en lokal visning av for eksempel ordre, lager eller produksjonstall. Koblet til en lokal modell på Tiiny kan denne typen arbeidsflyt skje i eget miljø: Tiiny leverer modellkraften, mens OMP fungerer som verktøyet som bygger løsningen. Det viser forskjellen på å ha en lokal AI-modell og å ha et komplett lokalt AI-arbeidsmiljø.
Dette vil ikke erstatte alle språkmodeller. Claude og ChatGPT vil fortsatt være bedre valg når du trenger svært sterke modeller, nettbaserte verktøy, fersk informasjon eller krevende analyse. Men benchmarken viser at mer arbeid kan flyttes lokalt enn mange kanskje tror. Personvernfølsomme og rutinepregede oppgaver trenger ikke alltid å sendes til skyen.
Hvor store modeller kan kjøre lokalt?
Tiinys kampanjemateriale oppgir støtte for modeller på opptil 120 milliarder parametere. Det betyr ikke at alle modeller i denne størrelsen blir raske eller like gode, men det viser at lokal AI ikke bare handler om de minste modellene. [2]
En viktig grunn er MoE, som står for «Mixture of Experts». En MoE-modell kan ha mange parametere totalt, men bruker bare noen av delene på hver oppgave. Derfor kan enkelte modeller med mange totale parametere kjøre på maskiner med 32 eller 96 GB minne, særlig når modellen er komprimert og bare deler av den brukes aktivt.
Det finnes likevel ingen enkel regel som sier at «120B alltid går på denne maskinen». Det avhenger av modellens oppbygning, komprimering, kontekstlengde og hvor mye minne som er tilgjengelig. Se på oppgitt modellstøtte som et utgangspunkt, og test den konkrete modellen dere faktisk vil bruke.
Tiiny, Claude/ChatGPT og RTX 5090
Claude og ChatGPT kjører vanligvis modellene hos leverandøren. Du slipper å kjøpe, oppdatere og drifte maskinvaren selv, og får tilgang til sterke modeller, søk og andre nettbaserte verktøy. Til gjengjeld må data behandles i en skytjeneste, og du er avhengig av abonnement, internett og leverandørens vilkår.
En PC med RTX 5090 er mye kraftigere enn Tiiny Pocket når målet er høy hastighet. RTX 5090 har 32 GB grafikkminne. NVIDIA oppgir 575 watt total grafikkeffekt, og et referansesystem anbefales med rundt 1 000 watt strømforsyning. Det er altså ikke selve RTX-kortet som bruker 1 000 watt, men en kraftig PC rundt kortet trenger en stor strømforsyning. [16]
En RTX 5090 vil normalt kjøre mange av de samme modellene raskere enn Tiiny. Den passer for deg som vil ha kort ventetid, teste flere modeller samtidig eller arbeide mye med lokal bildegenerering, kode og andre tunge oppgaver. Tiiny har på sin side en annen styrke: lavere strømforbruk, mindre drift og mulighet til å la en større eller mer krevende jobb gå over lengre tid uten at hastigheten er det viktigste.
Hva bør kjøres lokalt, og hva bør gå til skyen?
Kjør gjerne lokalt når:
- informasjonen er følsom, intern eller unødvendig å sende ut av virksomheten
- oppgaven gjentar seg, har tydelige rammer og ikke trenger fersk informasjon fra nettet
- du skal transkribere interne opptak, søke i godkjente dokumenter eller lage førsteutkast
- det er greit at oppgaven arbeider i bakgrunnen eller gjennom natten
- kostnaden ved mange skyforespørsler blir høyere enn kostnaden ved lokal drift
Bruk heller skyen når:
- oppgaven krever den sterkeste tilgjengelige modellen eller avansert resonnering
- du trenger nettsøk, oppdaterte data, eksterne verktøy eller samarbeid i sanntid
- resultatet må komme raskt og du ikke vil drifte maskinvare selv
- du trenger høy kvalitet på en uvanlig eller vanskelig oppgave
En enkel tommelfingerregel er derfor: Lokal AI når kontroll, personvern og kostnad veier tyngst. Sky-AI når kapasitet, hastighet og tilgang til verktøy veier tyngst. En hybridløsning kombinerer begge deler.
Når flere modeller jobber sammen: routing
Når dere har både lokale modeller og skymodeller, trenger dere ikke velge én løsning for alt. Routing betyr at et system sender hver oppgave til modellen som passer best. En enkel oppgave kan gå til Tiiny. En tung analyse kan gå til Claude eller ChatGPT. En bildegenerator eller kodemodell kan velges særskilt.
Det gir en mer praktisk AI-strategi enn å spørre «hvilken modell er best?». Spør heller: Hvilke oppgaver bør kjøres lokalt på grunn av personvern eller kostnad, og hvilke trenger høyere kapasitet? Les Kom i gang med AI-routing: Slik bruker du flere modeller uten kaos for en enkel innføring.
Hvor lokal AI kan være særlig interessant
| Område | Gode første forsøk med lokal AI | Viktig grense |
|---|---|---|
| Økonomi | Søke i godkjente rutiner, oppsummere bilagspakker, klargjøre møtenotater eller lage førsteutkast til interne avviksrapporter. | AI skal ikke bokføre, utbetale, tolke regelverk eller sende rapportering uten faglig kontroll og godkjenning. |
| HR | Finne informasjon i personalhåndbok, transkribere interne møter, strukturere kursmateriale eller lage utkast til stillingsbeskrivelse og onboarding. | Ikke bruk en modell til å rangere ansatte, treffe personalavgjørelser eller behandle mer persondata enn oppgaven krever. |
| Drift og kvalitet | Søke i prosedyrer, oppsummere vedlikeholdsnotater eller lage et førsteutkast til sjekkliste basert på godkjente kilder. | Fagansvarlig må fortsatt kontrollere resultatet før det blir en arbeidsinstruks eller beslutning. |
Dette er lesende, støttende arbeidsoppgaver der mennesket beholder ansvaret. Slik kan dere teste verdi uten å gi modellen makt til å endre økonomidata, sende følsom informasjon eller ta beslutninger på vegne av en leder.
Planlegg med 4D før dere velger modell
Før dere bestemmer om en oppgave skal gå lokalt, i skyen eller som en hybrid, bør dere avklare hva AI-en faktisk skal gjøre. 4D-rammeverket er nyttig her, også når oppgaven er teknisk:
| 4D-steg | Spørsmål før dere velger lokal modell eller skytjeneste |
|---|---|
| Delegering | Er dette en tydelig oppgave AI-en kan støtte: analysere en logg, lage et testutkast, søke i interne prosedyrer eller klargjøre kode for menneskelig gjennomgang? |
| Beskrivelse | Hvilke filer, systemer og verktøy trenger den — og hvilke skal den aldri få tilgang til? Hva er et godt nok resultat? |
| Dømmekraft | Hvordan skal resultatet prøves: testmiljø, kjente testtilfeller, stikkprøver eller faglig gjennomgang før bruk? |
| Aktsomhet | Hvem eier løsningen, når skal den stoppe, og hva gjør dere hvis den foreslår feil endring eller mangler informasjon? |
Dette gjør modellvalget mer konkret. Det er ikke nødvendig å bruke den største modellen på hver oppgave. Men det er heller ikke lurt å velge den minste bare fordi den kan kjøre lokalt. Den riktige kombinasjonen av modell, maskinvare, data, verktøy og kontroll avhenger av hva dere delegerer.
Mindre modeller kan allerede løse mer enn mange tror
Lokal AI er ikke lenger begrenset til enkle oppsummeringer. Nyere åpne modeller og bedre inferensverktøy kan, i egnet maskinvare- og testmiljø, støtte betydelige kodeoppgaver: orientere seg i et avgrenset kodeprosjekt, forklare feil, foreslå refaktorering, utforme testtilfeller, analysere logger og lage førsteutkast til dokumentasjon. Det betyr ikke at de overtar ansvaret for arkitektur, sikkerhet eller produksjonssetting. Men det betyr at terskelen for nyttig lokal kode- og analysehjelp er lavere enn før.
Videoen om FreeToken illustrerer dette godt: tekniske valg rundt modellformat, minne og inferensmotor kan avgjøre om en større lokal modell er praktisk å bruke på en reell kodeoppgave. [11] Evnen ligger derfor ikke bare i modellnavnet eller antall parametere. Den ligger også i hvordan modellen er kvantisert, hvilken maskinvare den får, hvor godt konteksten er valgt og hvilket harness som gir den verktøy, tester og kontrollsløyfer.
Det samme ser vi i økosystemet rundt GLM-5.3-Flash og lignende modeller. Det publiseres mange kvantiserte varianter, og vLLM har en åpen endring for modellstøtte. [12] [13] Dette er spennende for de som vil bygge lokalt, men ikke en grunn til å sette noe i drift ukritisk: den aktuelle vLLM-endringen er fortsatt åpen, og prosjektet skriver selv at bare første commit er fullt verifisert. Test med egne, ufarlige data i et isolert miljø før dere gjør en modell til del av en arbeidsprosess.
Hva dette betyr for økonomi, HR og teknisk arbeid
For økonomi og HR kan en lokal modell gjøre mer enn ren oppsummering: den kan hjelpe med å finne avvik i en godkjent prosedyre, foreslå testspørsmål til en intern rutine, sammenligne dokumentutkast eller gjøre et første søk i et avgrenset arkiv. Men vurderingen, godkjenningen og eventuelle endringer i kildesystemer må fortsatt eies av mennesker med riktig ansvar.
For utvikling og IT-drift kan lokale modeller være svært nyttige som en ekstra testpartner. De kan for eksempel lese en pull request, foreslå manglende enhetstester, se etter selvmotsigelser i konfigurasjon eller forklare hvor en feil kan ligge. De skal ikke få frie tøyler i produksjonsmiljøet, hemmeligheter eller administrative rettigheter. Verdien kommer av at de får et avgrenset problem, relevant kontekst og et tydelig sted å levere forslagene.
Ikke la kostnad eller «uncensored» styre ansvarsnivået
Det er naturlig å diskutere tokenpriser og avhengighet av store AI-leverandører. En lokal modell kan gi bedre kontroll over kostnad og dataflyt for noen oppgaver. Samtidig kommer driftskostnader, maskinvare, oppdateringer og kvalitetssikring i tillegg. Den gode løsningen er derfor ofte en portefølje: en mindre lokal modell der oppgaven er avgrenset, en sterk skymodell når kompleksitet eller fersk kunnskap krever det, og en mulighet til å bytte hvis pris, kapasitet eller vilkår endrer seg.
Det finnes også modellvarianter som markedsføres som «uncensored» eller «abliterated». Den delte Qwen3.8 Flash Next-kolleksjonen viser at slike varianter finnes i flere formater. [14] For Kakushin sin målgruppe er det ikke et argument for å fjerne sikkerhetsgrenser fra oppgaver med persondata, kunder eller produksjon. Dersom en slik modell vurderes for legitim defensiv testing av egen kode og infrastruktur, bør arbeidet skje i et autorisert, isolert testmiljø med testdata, logger og menneskelig ansvar. Dette fortjener en egen teknisk artikkel, med fokus på kvalitetssikring av systemer dere eier — ikke omgåelse av sikkerhet eller produksjonsdrift uten kontroll.
Jo mer kraftig modellen er, desto viktigere blir 4D: riktig delegering, presis beskrivelse, aktiv dømmekraft og aktsomhet i drift.
Fire gode første tester
- Transkriber ett internt møte lokalt. Sammenlign kvalitet, tidsbruk og hvordan dere håndterer lydfilen etterpå.
- Lag et lukket dokumentsøk. Gi AI-en en liten mappe med godkjente rutiner og se om den finner riktig informasjon uten å dikte.
- Kjør en daglig leserapport. La systemet oppsummere et avgrenset datasett, men la et menneske kontrollere før rapporten sendes videre.
- Test samme oppgave lokalt og i skyen. Mål kvalitet, responstid, kostnad, dataflyt og hvor lett det er å forklare hva som skjedde.
Det siste punktet er viktig. Mange sammenligner bare «føles modellen smart?». En bedre sammenligning er: Gir løsningen riktig svar på en oppgave som betyr noe, med riktig kontroll og til en kostnad og kompleksitet vi kan leve med?
Hvor passer dette inn i AI-strategien?
Start med prosesskartlegging før dere kjøper maskinvare. Når dere vet hvilken oppgave som faktisk skal løses, kan dere vurdere om lokal kjøring, sky eller en kombinasjon passer best. AI-orkestrering forklarer hvorfor modellen bare er én del av løsningen; kontekst, verktøy, kontrollpunkter og ansvar betyr minst like mye.
For den teknisk interesserte kan Qwen-artikkelen og Omarchy-artikkelen være gode neste steg. For resten av virksomheten er det ofte klokere å starte med én praktisk oppgave i systemene dere allerede bruker, og bygge videre først når dere kan se nytten.
Kilder
[1] Datatilsynet — Kunstig intelligens og personvern
[2] Tiiny AI Pocket Lab på Kickstarter
[4] NVIDIA Newsroom — NVIDIA DGX Spark Arrives for World’s AI Developers
[5] NIST — AI Risk Management Framework
[6] AudioXpress — Tiiny AI Pocket Lab ved CES 2026
[7] Caleb Writes Code — Qwen3.8 27B is something else
[8] Two Minute Papers — This Small AI Will Change Everything
[9] YouTube — DeepSeek Harness-video delt av Kakushin
[10] Tiiny AI — offisiell YouTube-kanal
[11] Better Stack — How They Fixed AI’s Biggest Local Hardware Problem (with FreeToken)
[12] vLLM — Pull request #53906: add GLM-5.3-Flash support
[13] Hugging Face — kvantiserte varianter av GLM-5.3-Flash
[14] Hugging Face — Qwen3.8 Flash Next Uncensored / Abliterated [15] Tiiny Pocket AI Model Benchmarks [16] NVIDIA — GeForce RTX 5090 specifications