Hvis du ber ChatGPT eller Claude om et svar, får du vanligvis tekst. Det er akkurat det de er laget for: forklare, skrive, kode og føre en samtale. Men når en applikasjon bare trenger å velge rett team for en kundehenvendelse, sette en risikoscore eller avgjøre om en sak skal til menneskelig kontroll, blir fri tekst ofte en omvei.
Typesafe AI lanserte i september 2026 Jev, en «System One Model» for slike beslutninger. I stedet for å generere ett ord om gangen, får Jev en tilstand og et sett med på forhånd definerte spørsmål. Den returnerer så strukturerte valg, score eller sant/usant-vurderinger med sannsynlighet og konfidens. [1] [2]
Jev er ikke en bedre chatbot. Den er en annen type grensesnitt: fra data og regler inn, til et strukturert valg programvaren kan bruke videre.
Bakgrunnen: fra ChatGPT-arbeid til automatisering
Typesafe ble grunnlagt av Diogo Almeida. I lanseringsartikkelen skriver han at han hos OpenAI var med på å utvikle metodene som gjorde språkmodeller bedre til å følge instruksjoner og føre samtaler, og at arbeidet endte opp som forskning bak ChatGPT. I et eget LinkedIn-innlegg omtaler han dette som å ha «co-invented ChatGPT». [1] [3]
Det er relevant bakgrunn for hvorfor Typesafe angriper et annet problem enn bedre chat: hvordan AI kan ta små, maskinlesbare beslutninger inne i programvare. Men bakgrunnen er ikke en garanti for at Jev passer i enhver arbeidsflyt. Påstandene om fart, kostnad og kvalitet må fortsatt testes på egne data og med egne kontrollpunkter.
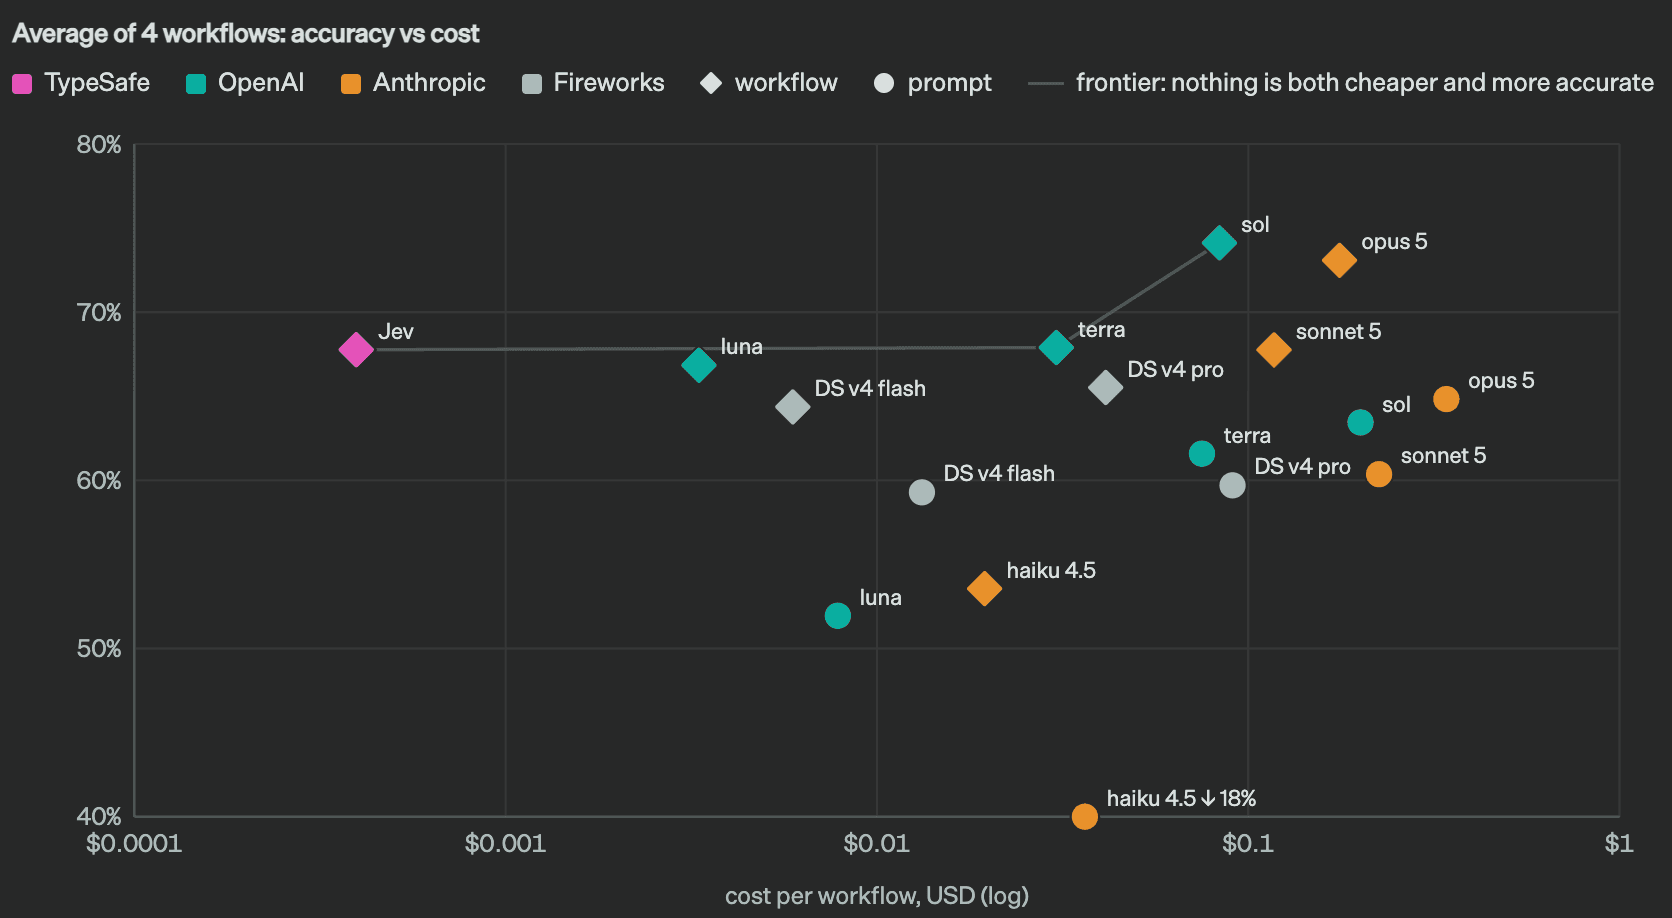
Typesafes egen forside har animerte produktvisualiseringer av beslutninger, kostnad og hastighet. Se originalvisualiseringene hos Typesafe. Med tillatelse fra Typesafe gjengir Kakushin også en utvalgt grafikk nedenfor. Den er brukt som støtte for forklaringen, ikke som en uavhengig dokumentasjon av ytelse.
Fra «skriv et svar» til «velg neste steg»
Et vanlig språkmodell-svar kan være nyttig, men en applikasjon må ofte tolke og kontrollere teksten før den tør å gjøre noe med den. Med Jev definerer utvikleren mulige svar på forhånd. Det gjør løsningen mer avgrenset, og dermed lettere å bygge inn i vanlig programvare.
| Spørsmål i en arbeidsflyt | Eksempel på strukturert svar | Hva programmet kan gjøre videre |
|---|---|---|
| Hvilket team skal håndtere henvendelsen? | salg, support eller økonomi, med sannsynligheter | Legge saken i riktig kø |
| Hvor hastende er saken? | Score fra lav til høy | Varsle vakttelefon ved høy score |
| Ber kunden om refusjon? | Sannsynlighet fra 0 til 1 | Sende tvetydige saker til en medarbeider |
| Bryter teksten med en godkjent regel? | Sant/usant + konfidens | Stoppe eller flagge et LLM-utkast før publisering |
Dette er i praksis «smarte if-setninger»: AI brukes der en hard regel blir for grov, men svaret må være presist nok til at resten av systemet vet hva det skal gjøre.
Hvorfor snakkes det om fart og pris?
Typesafe oppgir at Jev behandler definerte beslutninger parallelt, i stedet for å skrive svar token for token. I egne workflow-evalueringer rapporterer selskapet 193,6 ganger høyere fart og 444,6 ganger lavere kostnad enn sammenlignede modeller. Selskapet skriver selv at dette trolig er i øvre sjikt av reelle gevinster, og at evalueringene er laget av deres eget modellteam. [1]
Det er derfor mer nøkternt å lese tallene som et tegn på hvor interessant kategorien kan være, ikke som et løfte om at alle oppgaver blir 200 ganger raskere eller 400 ganger billigere.
| Når et LLM fortsatt passer best | Når Jev-lignende beslutningsmodell kan passe |
|---|---|
| Skrive e-post, rapport, tilbud eller kundesvar | Rute e-posten til rett kø før noen skriver svaret |
| Forklare et komplekst dokument | Trekk ut på forhånd definerte felt og flagg manglende opplysninger |
| Lage kode eller foreslå en løsning | Score om et forslag følger en bestemt policy eller sjekkliste |
| Resonnere rundt uventede eller åpne spørsmål | Vurdere mange ensartede saker med samme spørsmål |
Tre realistiske brukstilfeller
1. Kundehenvendelser uten at en agent får frie hender
En bedrift kan sende innholdet i en ny henvendelse sammen med åpningstider, produktkategorier og enkle regler. Systemet spør: «Er dette salg, support eller økonomi?», «Haster det?» og «Mangler vi nødvendig informasjon?». Jev kan levere tre strukturert svar samtidig. Systemet kan plassere saken i riktig kø, men må fortsatt la et menneske godkjenne pris, avtaler og utsendelser.
2. Dokument- og ERP-flyt med tydelige stopper
Tenk en innkommende faktura eller en kvalitetsrapport. En beslutningsmodell kan brukes til å klassifisere dokumenttype, vurdere om et referansenummer ser ut til å mangle og gi en risiko- eller avviksscore. Det kan spare tid før en medarbeider tar saken, men det skal ikke være grunnlag alene for bokføring, betaling eller endring av data i ERP-systemet.
3. Et kontrollpunkt rundt mer åpne AI-modeller
I et harness kan en generativ modell fortsatt skrive utkast eller analysere et vanskelig dokument. En Jev-lignende beslutningsmodell kan ligge rundt den og spørre helt konkrete kontrollspørsmål: følger utkastet en policy, inneholder det personopplysninger, eller er usikkerheten høy nok til at et menneske må se det? Dette er ikke en garanti for trygghet, men det gir et tydeligere kontrollpunkt enn et generelt «vær forsiktig»-prompt.
«Ingen typefeil» er ikke det samme som «aldri feil»
Noe av markedsføringen er lett å misforstå. Når Typesafe sier at Jev ikke kan ha typefeil, mener de at svaret følger det forhåndsdefinerte skjemaet. Hvis alternativene er salg, support og økonomi, får programmet et av disse alternativene i riktig struktur. [1]
Det betyr ikke at modellen alltid velger riktig alternativ, at datagrunnlaget er godt nok eller at forretningsregelen er fornuftig. Typesafe presiserer selv at kalibrering måles på grupper av prediksjoner og ikke garanterer at hvert enkelt svar er korrekt. [2]
| Dette kan være kontrollert | Dette må dere fortsatt teste og eie |
|---|---|
| At svaret passer et teknisk skjema | Om kategoriene og tersklene er riktige for deres bedrift |
| At sannsynlighet følger med svaret | Om sannsynligheten faktisk er godt kalibrert på deres data |
| At programmet kan lese svaret uten teksttolking | Om handlingen etter svaret er reverserbar og godkjent |
| At modellen er rask på en avgrenset oppgave | Personvern, datatilgang, logging og menneskelig ansvar |
Jev er en skytjeneste — Laya-MLX viser hva et lokalt alternativ krever
Jevs offentlige dokumentasjon beskriver SDK- og HTTP API-bruk. Det er derfor mest riktig å se Jev som en skytjeneste i tidlig tilgang, ikke som en lokal modell dere kan laste ned til egen PC. [2] Har dere strengere krav til dataflyt, må dere fortsatt vurdere om data kan sendes til tjenesten, hvilke avtaler som gjelder og om en lokal eller privat modell er mer egnet.
Laya er relevant her, men er ikke Jev i lokal innpakning. Laya er et separat, åpent prosjekt for samme type avgrensede spørsmål: valg, skala og sannsynlighet for sant/usant. Laya-MLX er igjen en uavhengig MLX-port av Laya-modellene, laget for lokal kjøring på Apple Silicon. Prosjektet oppgir at modellen lastes ned første gang og deretter kan gjøre inferens lokalt på maskinen. Det er ingen offisiell TypeSafe-integrasjon eller dokumentert identitet mellom Laya og Jev. [4] [5]
Hva Laya tilfører i praksis
Laya er interessant fordi det er mye mindre enn en typisk generell språkmodell og er laget for typed decisions fremfor tekstgenerering. Oppstrømsprosjektet beskriver blant annet en engelsk modell på 421 millioner parametere, en flerspråklig modell på 322 millioner parametere og en variant for typed-decision-arbeidsflyter. De samme tre primitivene går igjen: `choice`, `score` og `noul` – altså velg et alternativ, gi en skår eller vurder sannheten i et utsagn. [4]
For en Mac med Apple Silicon gjør Laya-MLX dette konkret. Prosjektet oppgir lokalt MLX-oppsett med Python 3.11 eller nyere og macOS 14 eller nyere. På utviklerens M3 Max-testmaskin oppgis korte, flerspråklige beslutninger på få millisekunder og under én GiB toppallokering for én kort forespørsel. Det er prosjektets egne målinger på én maskin, ikke et løfte om samme hastighet på en vanlig MacBook eller på lange norske dokumenter. [5]
Den flerspråklige modellen gjør Laya mer interessant for norsk enn en ren engelsk modell, men den er ikke dokumentasjon på at resultatene er gode nok på norske kundehenvendelser eller fagtekster. Laya-MLX advarer selv om at den engelske modellen ikke skal brukes som erstatning for den flerspråklige, og at confidence ikke garanterer riktig svar. Derfor bør en norsk pilot måle både riktig valg og om modellen vet når den er usikker. [5]
| Spørsmål | Jev | Laya / Laya-MLX |
|---|---|---|
| Driftsform | Dokumentert som SDK- og HTTP API-tjeneste. | Åpne modeller og kode kan kjøres i eget miljø; Laya-MLX er spesifikt bygget for Apple Silicon. |
| Beslutningsform | Choice, Score og Noul med strukturerte svar og sannsynligheter. | Beslektede primitives: choice, score og noul, med strukturerte svar og sannsynligheter. |
| Hvem drifter | Leverandøren drifter modell- og API-laget. | Dere eller en teknisk partner må eie maskin, oppdateringer, tilgang, logger, backup og overvåking. |
| Hva må bevises | At tjenesten og tersklene fungerer på deres saker. | Det samme, i tillegg til at valgt checkpoint, språk, maskinvare og lokal runtime er egnet for deres drift. |
For en bedrift med sensitiv dokumentflyt kan et lokalt spor være interessant, men «lokalt» er ikke det samme som ferdig sikret eller klart for produksjon. Laya-MLX krever Apple Silicon, Python og lokal modellhåndtering. Førstegangsoppsett, minneforbruk, oppdateringer og tilgang til maskinen må planlegges. Særlig for norske dokumenter bør dere teste egne representative saker; et flerspråklig checkpoint eller en oppgitt sannsynlighet er ikke i seg selv bevis på god norsk kvalitet eller kalibrering. [4] [5]
Laya-prosjektet publiserer også sammenligninger mot Jev. De kan være nyttige som tekniske hypoteser, men ikke som en innkjøpsfasit: Laya-tallene er prosjektets egne målinger, mens Jev-tallene i sammenligningen er hentet fra tredjepart og ikke nødvendigvis bruker samme datasett, spørsmål eller driftsforhold. Den rettferdige testen er å kjøre begge mot de samme, godkjente eksemplene fra egen arbeidsflyt og måle feil, svartid og behovet for menneskelig overtakelse. [4]
Jev vs. Laya: det viktigste skillet i praksis
Videoen over bruker bildet «lukket boks» mot «glassboks». Det er en nyttig forenkling, men ikke hele svaret. Jev er en administrert TypeSafe-tjeneste med dokumentert API og et ferdig beslutningsformat. Laya publiserer åpen kode og åpne vekter under Apache 2.0, slik at modellen kan kjøres og undersøkes i eget miljø. Laya-MLX er en separat Apple-Silicon-port av Laya – ikke en lokal utgave av Jev. [2] [4] [5]
| Det dere egentlig velger mellom | Jev | Laya / Laya-MLX |
|---|---|---|
| Startpunkt | Kall en leverandørdrevet API fra egen arbeidsflyt. | Installer modell og runtime selv, eller bruk en teknisk partner. |
| Dataflyt | Data sendes til API-et, så avtale, region, logging og dataminimering må vurderes. | Data kan behandles lokalt, men bare hvis hele løsningen – modeller, logger, backup og integrasjoner – faktisk holdes i eget miljø. |
| Kostnadsbilde | Løpende API-kostnad og mindre ansvar for modellserveren. | Ingen løpende tokenpris til en modell-API, men maskin, strøm, oppdateringer, overvåking og teknisk tid er fortsatt en kostnad. |
| Mange kategorier | TypeSafe dokumenterer at én Choice kan ha opptil 255 alternativer. | Laya sine egne benchmarks anbefaler foreløpig å holde én Choice under omtrent 20 alternativer, eller dele opp klassifiseringen i trinn. [2] [11] |
| Tilpasning | Definer spørsmål, kriterier og terskler rundt API-et. | Kode og vekter kan eies lokalt; Laya dokumenterer også finjustering, som krever merkede eksempler og egen evaluering. [4] |
Den praktiske forskjellen er derfor ikke at den ene «alltid er best». Jev kan være enklere når dere vil teste raskt med en leverandørdrevet tjeneste og en tydelig API-kontrakt. Laya er interessant når lokal drift og mulighet til å tilpasse eller undersøke løsningen veier tyngre enn enkel oppstart. Har dere bare tre enkle regler, er det ofte bedre å bruke vanlige regler og en menneskelig kø enn å innføre en beslutningsmodell i det hele tatt.
Ikke bruk videoens prosenttall som fasit
Videoen viser tall for fart, pris og treffsikkerhet, blant annet på oppgaver med få og mange kategorier. De gir en god forklaring på hvorfor alternativene har ulike styrker, men de er ikke en felles, uavhengig test av deres kundesaker. Laya sitt eget benchmarkdokument sier også eksplisitt at Jev-tallene der er publiserte tredjepartstall som ikke er målt i samme oppsett. [11] Videoens tall bør derfor leses som leverandør- og prosjektpåstander, ikke som en innkjøpsfasit. [12]
Det samme gjelder påstanden om at en modell «ikke hallusinerer». Begge er bygget for å returnere et begrenset svarformat i stedet for fri tekst. Det reduserer risikoen for uventede tekstsvar, men det beviser ikke at valget er faglig riktig. Laya dokumenterer selv både språkruting, begrensninger i konfidens og behovet for temperaturkalibrering. Jev dokumenterer på sin side at konfidens beskriver hvordan sannsynlighetene fordeler seg, ikke en garanti for korrekthet. [2] [4]
En rettferdig test for en norsk bedrift
Velg 100–200 avsluttede, godkjente saker som dere allerede kjenner fasiten på. Mål riktig kategori, hvor ofte saken må til menneskelig kontroll, svartid og reell kostnad. Hvis norsk språk er viktig, test det separat; ikke anta at en engelsk modell eller et flerspråklig navn alene gir god nok kvalitet. Test også hva som skjer med få kategorier, med mange kategorier og med uklare henvendelser.
For mange virksomheter vil det fornuftige første valget fortsatt være et enkelt beslutningsledd foran en språkmodell: Jev eller Laya velger kø og risikonivå, mens Claude eller en annen språkmodell lager utkastet. Men start lesende og reversibelt. Ingen av modellene bør selv sende, bokføre, betale eller endre kundedata uten tydelige regler og menneskelig godkjenning.
Jev og Laya-MLX er heller ikke ferdige agenter som kan gå inn i e-post, CRM eller filsystem og gjøre arbeid på egen hånd. De kan bli effektive beslutningsledd i en større arbeidsflyt, men noen må fortsatt bygge integrasjonen, sette tilganger, definere regler og overvåke resultatet.
Videre lesning: Jev Decision Index
Vil dere se hvordan åpne prosjekter og alternative tilnærminger testes mot Jev-lignende beslutningsoppgaver, les Jev Decision Index. Indeksen er en uoffisiell, fellesskapsdrevet oversikt over reproduksjoner og beslektede modeller. Den er nyttig for å finne kandidater og forstå testmetodikk, men erstatter ikke en pilot med egne data.
Slik kan en liten bedrift teste ideen
Start med én lesende og reverserbar oppgave. Velg tre til fem spørsmål som medarbeidere allerede svarer ofte, eksempelvis «hvilken kategori?», «hvor hastende?» og «må dette sees av menneske?». Kjør løsningen parallelt med dagens arbeidsmåte, og sammenlign svarene med menneskelig vurdering før dere lar resultatet påvirke kø eller prioritet.
Dette er samme modne start som i 4D-rammeverket: avgrens oppgaven, beskriv regler og stoppunkter, test dømmekraften mot virkelige saker og behold aktsomhet når noe avviker. Først når dere kan måle at prosessen sparer tid uten å øke feil, er det fornuftig å gjøre mer.
OpenAI Decisions: en parallell løsning for strukturerte valg
OpenAI har nå lansert Decisions API i public beta. Det er et eget API for å vurdere tekst, bilder eller begge deler og returnere typede svar som programvare kan bruke videre. OpenAI beskriver det som omtrent ti ganger raskere enn Responses API for denne typen oppgaver, men det er OpenAIs egen sammenligning – ikke en uavhengig benchmark mot Jev. [8]
Decisions har tre sentrale spørsmålstyper:
- `predicate`: Hvor sannsynlig er det at en bestemt påstand er sann? For eksempel om et produktbilde viser synlig skade.
- `choice`: Hvilket alternativ passer best? For eksempel salg, support eller økonomi.
- `score`: Hvor høyt scorer saken på en ordnet skala? For eksempel lav, middels eller høy alvorlighetsgrad.
Svaret kommer med sannsynligheter eller en score som utvikleren kan bruke til å rute, prioritere eller sende saken til menneskelig kontroll. OpenAI viser blant annet bruk for klassifisering av kundehenvendelser og vurdering av bilder. API-et bruker foreløpig modellen `gpt-6-luna` gjennom et eget `/v1/decisions`-endepunkt, og dokumentasjonen sier at løsningen fortsatt er i public beta. [8]
Dette gjør Decisions relevant å sammenligne med Jev. Begge retningene handler om å få AI til å svare på avgrensede spørsmål i stedet for å produsere lange fritekstsvar. Forskjellen er at de kommer fra ulike leverandører, har ulike modeller og ulike driftsvilkår. OpenAI Decisions er en tjeneste i OpenAI-plattformen. Jev er Typesafes eget System One Model og API.
Det er derfor for tidlig å skrive at OpenAI har «slått ut» Jev. Innlegget som inspirerte denne oppdateringen bruker formuleringen «Jev killer», men den offisielle Decisions-dokumentasjonen dokumenterer ikke en direkte Jev-sammenligning. [9] Det riktige spørsmålet for en bedrift er heller: Hvilken løsning gir best kvalitet, pris, datakontroll og drift på akkurat våre beslutningsoppgaver?
For enkelte virksomheter kan OpenAIs løsning være enkel å teste fordi den passer inn i en eksisterende OpenAI-integrasjon. Dokumentasjonen oppgir også støtte for Zero Data Retention, HIPAA og datalagring eller regional behandling i USA og Europa for kunder som oppfyller vilkårene. Dette må vurderes mot avtale, datatyper og behandlingsgrunnlag; det betyr ikke automatisk at alle oppsett er GDPR-klare. [8]
I praksis kan Decisions og Jev brukes på samme type arbeidsflyt som beskrevet over: et beslutningsledd sorterer eller scorer saken, mens Claude eller en annen språkmodell skriver forklaringen og utkastet. Men velg én løsning i første pilot. Kjør den mot de samme godkjente eksemplene, mål riktig klassifisering, svartid, kostnad og behovet for menneskelig overtakelse, og sammenlign først etterpå.
Jev i praksis: mange små vurderinger i sanntid
En nyere kort demonstrasjon viser Jev brukt som et raskt filter for mange avgrensede vurderinger. Eksemplene handler blant annet om å vurdere fakturasvindel, sortere annonser mot ulike kjøperprofiler, analysere mange annonsevarianter og gi skår til annonsesett basert på historiske kriterier. [10]
Det interessante i eksemplene er ikke at Jev skal erstatte Claude eller gjøre all markedsføring automatisk. Det er at en beslutningsmodell kan vurdere mange ensartede spørsmål på rad, mens en språkmodell eller et menneske tar seg av forklaringen, unntakene og den endelige beslutningen.
Videoen er en produktdemonstrasjon, og påstandene om fart, pris og resultat må derfor testes på egne data. Den viser heller ikke at en modell automatisk forstår en kjøperprofil riktig eller at en annonse bør stoppes uten kontroll. Bruk den som inspirasjon til hva som kan bygges, ikke som en uavhengig benchmark.
Jev + Claude: Én velger, én skriver
En aktuell video om Jev viser et nyttig arkitekturmønster: Jev tar de små, raske valgene, mens Claude gjør den åpne delen av arbeidet. Jev kan for eksempel vurdere om en henvendelse er salg eller support, gi en risikoscore eller avgjøre om saken bør sendes videre. Claude kan deretter skrive et svarutkast, undersøke et dokument eller lage kode når oppgaven faktisk krever språk og resonnement. [6]
Dette er ikke en konkurranse om hvilken AI som skal gjøre alt. Det er en arbeidsdeling. Jev returnerer strukturerte valg som programmet kan bruke til å route, sortere eller stoppe. Claude passer bedre når resultatet skal være tekst, forklaring, kode eller et forslag som et menneske skal vurdere. [2]
Videoen viser blant annet innboks-sortering, routing og vurdering av fakturaer. Den bør leses som en produktdemonstrasjon av et mulig oppsett. Tallene som vises for fart og kostnad er ikke en uavhengig benchmark på norske kundehenvendelser eller deres egne data. Før en slik løsning brukes i praksis, må dere teste samme oppgave med samme datagrunnlag og måle feil, svartid, kostnad og hvor ofte et menneske må overta.
I et virkelig system trenger dere også et harness rundt begge modellene. Det bestemmer hvilke dokumenter som kan leses, hvilke verktøy som kan brukes, hva som skjer ved lav konfidens, og hvem som må godkjenne før en melding sendes eller en faktura endres. Jev kan være et beslutningsledd i harnesset, men det erstatter ikke tilgangsstyring, logging, tester eller menneskelig ansvar. [7]
Et enkelt eksempel kan se slik ut:
- Jev klassifiserer en ny henvendelse som salg, support eller økonomi.
- Hvis saken er uklar eller sensitiv, går den til en medarbeider.
- Claude lager et førsteutkast basert på godkjente kilder.
- Et kontrollpunkt sjekker at utkastet følger en policy.
- Et menneske godkjenner før noe sendes til kunden.
Dette er mer realistisk enn å gi én agent fri tilgang til innboks, CRM og økonomisystem. Det gir også en tydeligere måte å bytte modell på senere: Beslutningsleddet og skriveleddet kan testes hver for seg, mens reglene rundt dem ligger fast.
Hva betyr dette for agentarbeid?
Jev er interessant fordi agentarbeid ofte blir dyrt og uforutsigbart når én stor språkmodell får gjøre alle små vurderinger. På sikt kan en god arbeidsflyt bruke en sterk språkmodell til plan, forklaring og unntak, mens en mer avgrenset beslutningsmodell håndterer mange raske valg underveis. Der data ikke bør forlate en kontrollert Mac eller intern maskin, kan Laya-MLX være et lokalt spor å undersøke — men bare etter en avgrenset test og med tydelig driftsansvar.
Jev er ny og fortsatt i early access. Laya og Laya-MLX er også nye, raskt utviklende prosjekter. Den riktige holdningen er derfor nysgjerrig, men kontrollert: test på avgrensede data, mål kvaliteten på egne saker og ikke gi en ny tjeneste eller lokal installasjon tilgang til kundedata eller forretningskritiske systemer før personvern, kontrakter, logging og ansvar er avklart.
Kilder
[1] TypeSafe AI — Introducing System One Models & Jev
[2] TypeSafe AI Docs — Introduction og System One
[3] Diogo Almeida på LinkedIn — egen beskrivelse av tidligere ChatGPT-arbeid
[4] Laya — åpen, ikke-autoregressiv beslutningsmodell med benchmarks og dokumenterte begrensninger
[5] Laya-MLX — uavhengig MLX-runtime for Laya-modeller på Apple Silicon
[6] YouTube — demonstrasjon av Jev i et agentisk arbeidsmiljø sammen med Claude
[7] Walking Labs — Learn Harness Engineering
[8] OpenAI Developers — Decisions API
[9] The AI Automation Society — omtale av OpenAI Decisions
[10] YouTube — The Wildest Jev AI Use Cases (Including My Ad Account)
[11] Laya — benchmarks, testmetode og dokumenterte begrensninger
[12] YouTube — Jev vs Laya Explained: TypeSafe AI vs the Open-Source Rival