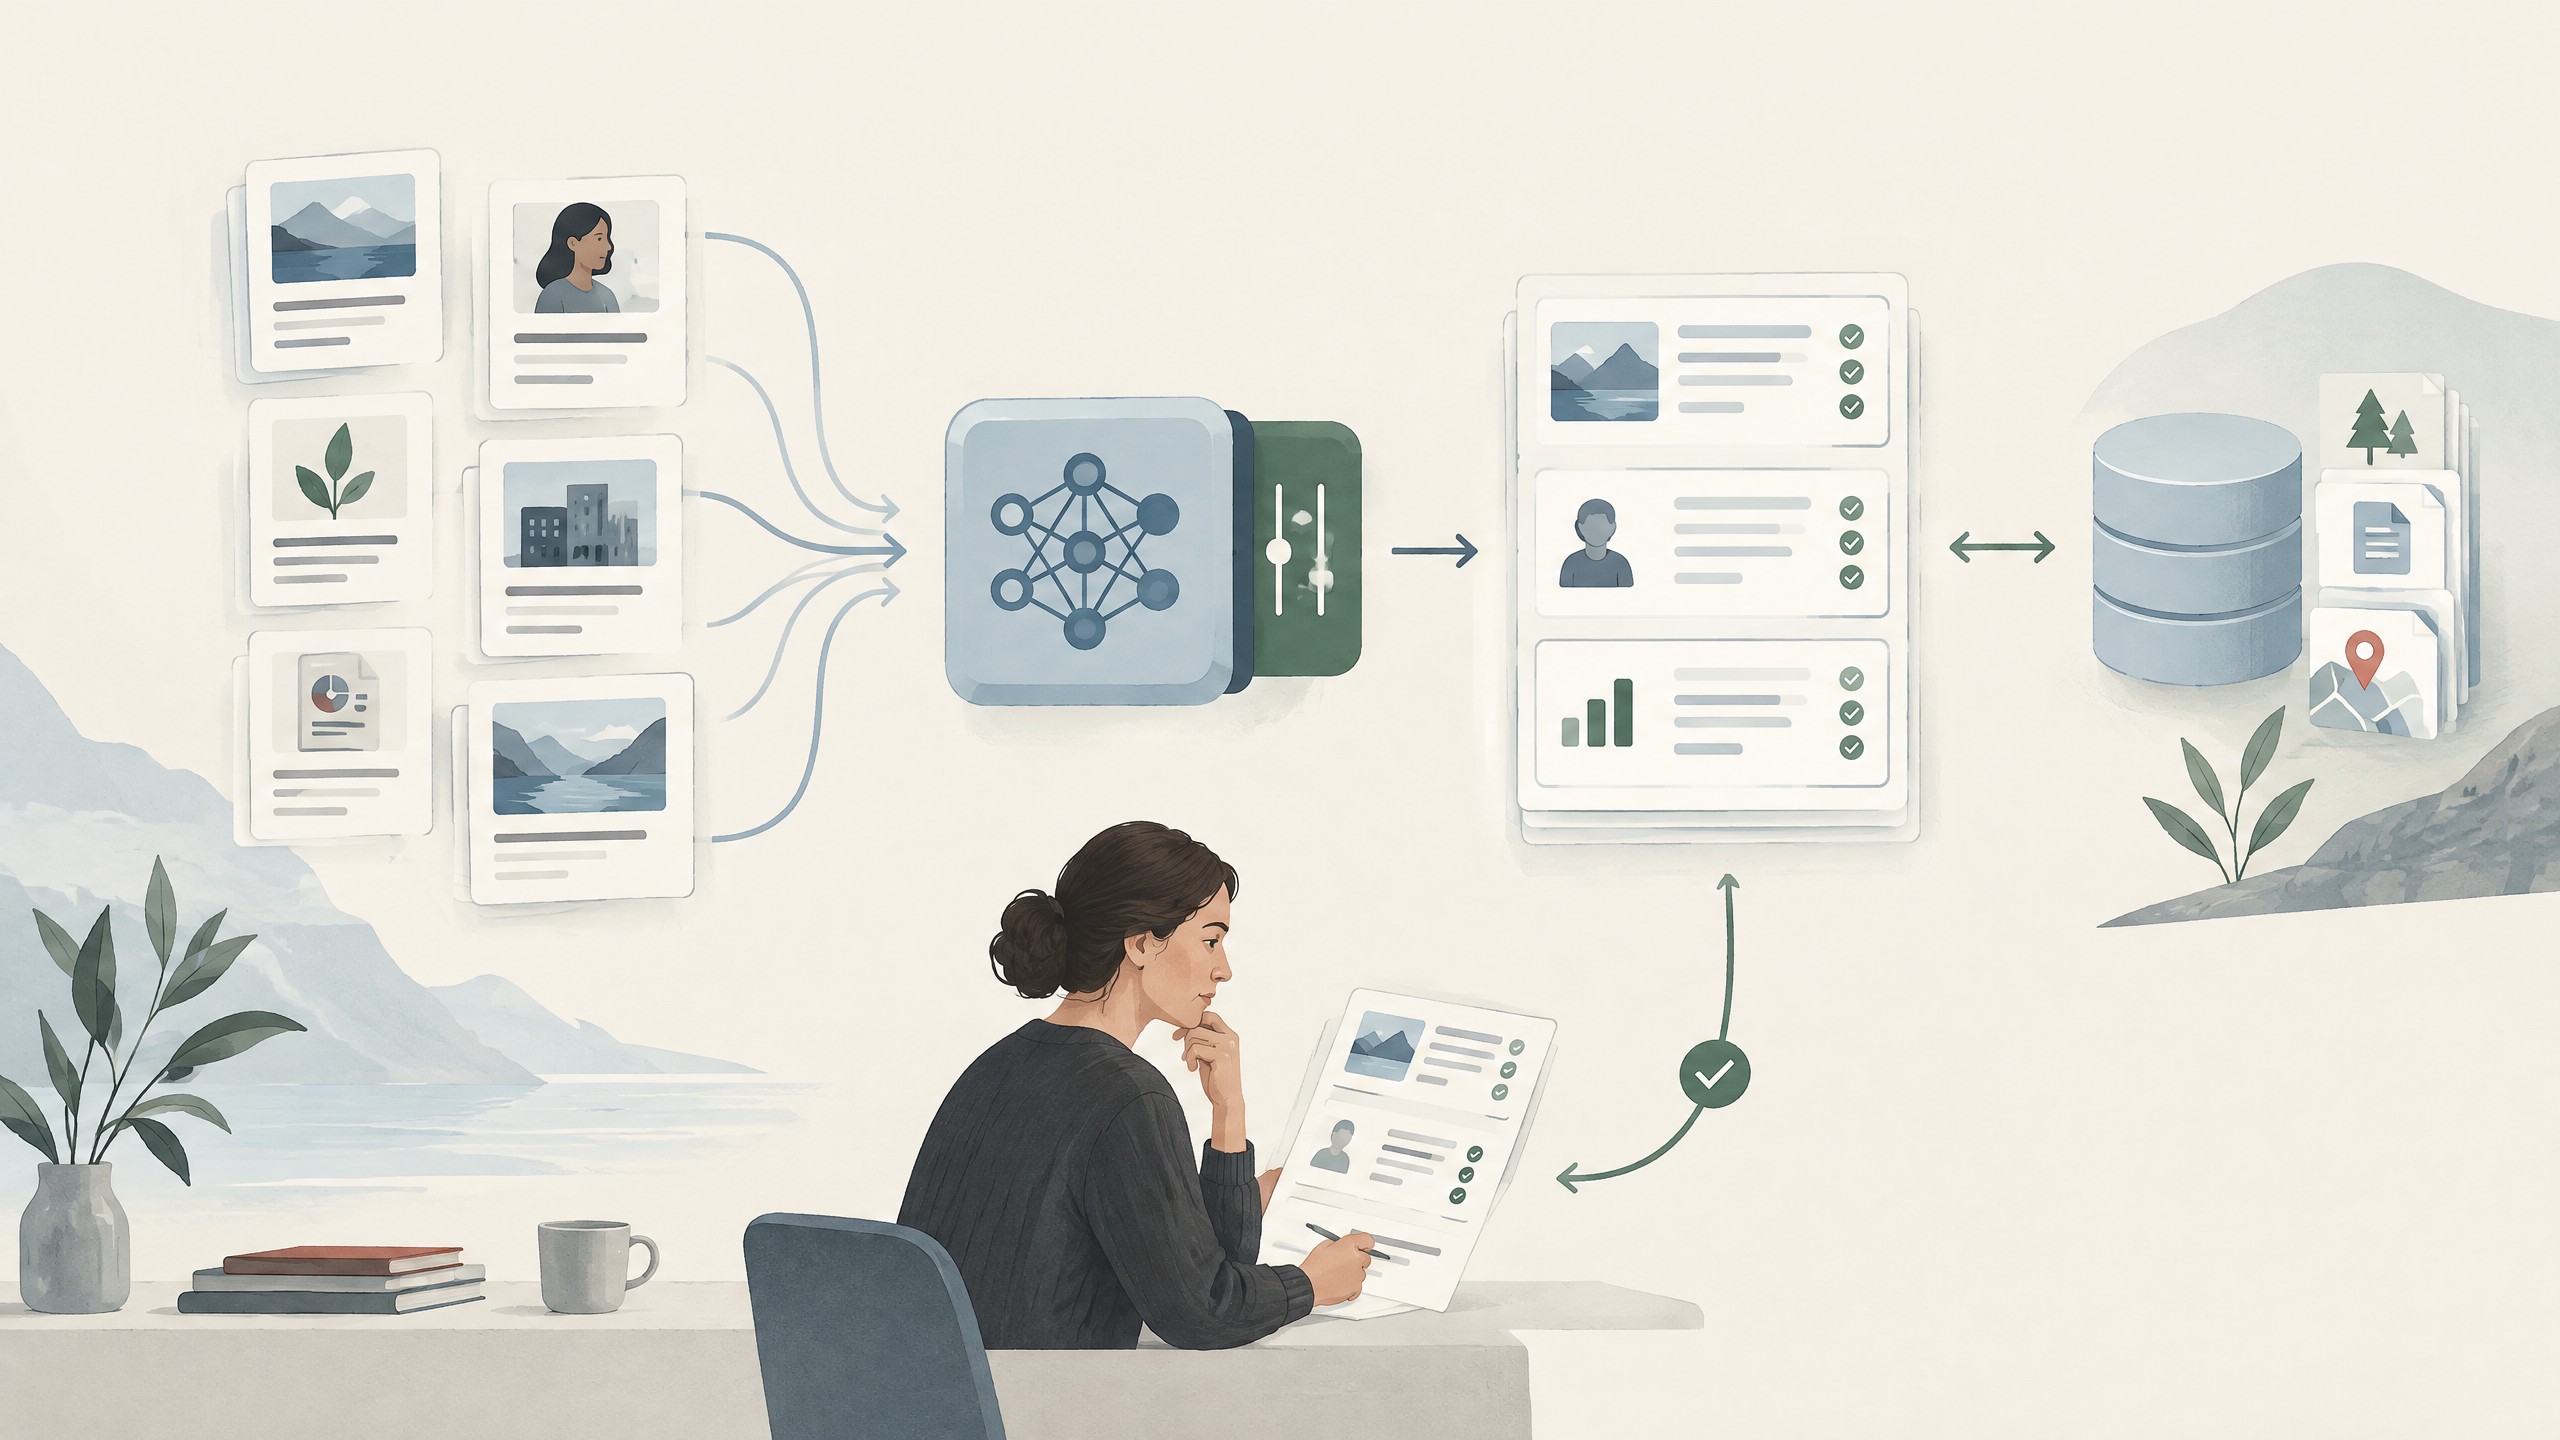
Finetuning betyr at du tar en eksisterende AI-modell og trener den videre på eksempler fra en bestemt oppgave. Målet er vanligvis ikke å gi modellen «all kunnskap om bedriften». Målet er å gjøre den mer stabil i måten den svarer, klassifiserer eller formaterer på.
Det korte Instagram-innlegget som inspirerte denne artikkelen forklarer finetuning med katter. Det er en god inngang fordi ideen kan være enkel: Vis modellen mange gode eksempler på en oppgave, slik at den lærer mønsteret. Den viktige fotnoten er at dette ikke er magi. Dårlige, skjeve eller utdaterte eksempler kan også lære modellen dårlige vaner.
For de fleste små og mellomstore bedrifter bør finetuning komme etter at dere har prøvd tydelige instruksjoner og en ryddig kunnskapsbase. Det er ikke første steg for å få en AI-assistent til å kjenne bedriften deres.
Hva lærer modellen ved finetuning?
En språkmodell er trent på store mengder generell tekst. Med finetuning viser dere den mange par med ønsket input og ønsket output. Den tilpasses slik at den i større grad følger mønsteret i deres eksempler.
Et eksempel kan være en bedrift som mottar servicehenvendelser. Dere kan trene en modell til å returnere akkurat dette formatet hver gang:
- kategori
- hastenivå
- manglende opplysninger
- forslag til neste steg
- et kort svarutkast i virksomhetens tone
Det som læres er først og fremst en arbeidsmåte. Hvis åpningstider, priser eller produktdetaljer endrer seg neste uke, er finetuning normalt ikke den beste måten å oppdatere det på.
Finetuning, instruksjoner eller kunnskapsbase?
Det er lett å bruke «tren på våre data» som svar på alle AI-spørsmål. Ofte er et annet grep bedre.
| Behov | Vanligvis best første valg | Hvorfor |
|---|---|---|
| Modellen mangler en enkel regel eller tydelig tone | Bedre instruksjoner og eksempler i prompten | Raskt å endre og lett å teste. |
| Modellen trenger aktuelle fakta, priser eller dokumenter | Kunnskapsbase med tydelige kilder | Fakta kan oppdateres uten ny trening. |
| Modellen må følge samme format eller klassifiseringsmønster tusenvis av ganger | Finetuning eller en mindre adapter | Kan gjøre atferden mer stabil og forespørslene kortere. |
| Oppgaven har høy risiko eller uenighet om fasit | Menneskelig prosess og tydelige regler først | Ingen modelltilpasning erstatter ansvar eller faglig kontroll. |
En kunnskapsbase kan for eksempel bygges som en ryddig Obsidian Vault med LLM Wiki. Da ligger oppdatert informasjon i dokumentene, og AI-en får hente den når den trenger den. Det er mer passende enn å bake endrede priser, policyer eller produktfakta inn i modellvektene.
Når finetuning faktisk kan være nyttig
Finetuning kan være et godt valg når oppgaven er stabil, hyppig og målbar. Det kan for eksempel være:
- å trekke ut faste felter fra like typer skjemaer
- å sette henvendelser i riktig kategori
- å lage førsteutkast som alltid følger en godkjent mal
- å oversette gjentakende fagtekster med faste termer
- å gi konsistente svar i en intern støttefunksjon
- å gjøre en mindre, lokal modell god på én avgrenset oppgave
Den største gevinsten kommer ofte ikke av at modellen «blir smartere». Den kommer av at en enklere modell kan gjøre en smal oppgave mer forutsigbart, raskere eller med mindre prompttekst. Det kan være interessant når løsningen brukes mange ganger hver dag.
Når finetuning er feil verktøy
Ikke bruk finetuning som snarvei når problemet egentlig er manglende prosess eller dårlig data. Det er et dårlig valg når:
- fakta endrer seg ofte
- dere ikke har klart å definere hva et godt svar er
- eksemplene er blandet, ufullstendige eller inneholder personopplysninger dere ikke bør bruke
- oppgaven skjer så sjelden at enklere instruksjoner er billigere
- en feil kan få juridiske, økonomiske eller menneskelige konsekvenser uten at noen kontrollerer resultatet
Finetuning løser heller ikke problemet med at modellen kan finne på ting. Den kan bli mer konsekvent i format og stil, men den trenger fortsatt kilder, validering og en tydelig plan for usikre svar.
Et enklere teknisk ord: LoRA og PEFT
Det er ikke alltid nødvendig å trene alle vektene i en stor modell på nytt. Metoder som PEFT (parameter-effektiv finetuning) tilpasser bare en mindre del av parameterne. En vanlig variant er LoRA, der en liten adapter lærer oppgaven ved siden av basismodellen.
Det kan redusere trenings- og lagringsbehovet betydelig. Hugging Face beskriver PEFT som en måte å tilpasse store forhåndstrente modeller uten å finetune alle parameterne, noe som kan gjøre eksperimenter med åpne modeller mer tilgjengelige på mindre maskinvare.
Men «mindre adapter» betyr ikke «ingen drift». Dere trenger fortsatt et grunnmodellvalg, gode data, testeksempler, versjonskontroll og en plan for hva som skjer når modellen eller dokumentene endrer seg.
Den viktigste delen: evaluer før og etter
En finetuning uten testsett er bare en dyr gjetning. Før dere trener, bør dere samle eksempler som representerer reelle saker. Hold noen av dem utenfor treningen. De brukes kun for å sammenligne modellen før og etter tilpasningen.
En enkel prosess kan være:
- Velg én oppgave og beskriv hva som er et godt resultat.
- Samle eksempler som dekker normale saker, grensetilfeller og tydelige feiltilfeller.
- Del dataene i treningssett og et separat testsett.
- Test en vanlig modell med gode instruksjoner først.
- Tren en liten pilot hvis den samme feilen eller formatutfordringen går igjen.
- Sammenlign resultat, svartid, kostnad og feil før og etter.
- La en fagperson kontrollere de feilene som betyr mest.
Dette er samme tankegang som Jev Decision Index: En score er bare nyttig når dere vet hva som er testet, hvilke feil som skjuler seg bak gjennomsnittet og om testen ligner deres virkelige arbeid.
Personvern, rettigheter og drift
Treningsdata er ikke bare «eksempler». Det kan inneholde kundedata, avtaler, e-post, helseopplysninger, interne vurderinger eller opphavsrettslig materiale. Før dere bruker data til trening, må dere vite:
- har dere rett til å bruke materialet til dette formålet?
- inneholder det personopplysninger eller forretningshemmeligheter?
- hvor lagres data og modelladaptere?
- hvem kan hente ut eller kopiere treningssettet?
- hvordan sletter dere data eller oppdaterer en modellversjon?
- er det mulig å forklare og kontrollere feil i den aktuelle oppgaven?
Lokal kjøring kan gi mer kontroll over dataflyten, men gjør ikke løsningen automatisk sikker eller lovlig. Artikkelen om offline AI forklarer noen av avveiningene mellom lokal maskin og sky.
Start med en liten, målbar pilot
En fornuftig første pilot kan være å gjøre et internt skjema mer konsistent. La en modell foreslå kategori og strukturert sammendrag, men ikke la den sende noe eller endre kundedata. Sammenlign først resultatet med det en erfaren medarbeider ville gjort.
Hvis pilotdataene viser at finetuning gir merkbart færre feil eller mindre manuelt arbeid enn instruksjoner og kunnskapsbase alene, kan det være fornuftig å gå videre. Hvis ikke, har dere lært noe verdifullt uten å bygge unødvendig teknisk gjeld.
Trendslop-artikkelen utdyper hvorfor det er klokt å unngå avansert AI-arkitektur før problemet, kildene og evalueringskriteriene er tydelige.
Konklusjon: lær stabil atferd, ikke lag et faktaarkiv i modellvektene
Finetuning er et nyttig verktøy når dere trenger stabil atferd på en avgrenset, hyppig og målbar oppgave. Det passer godt for faste formater, klassifisering og virksomhetsspesifikke svarmønstre.
Det er normalt ikke riktig verktøy for stadig nye fakta, uklare prosesser eller oppgaver der konsekvensen av feil er stor. Start med gode instruksjoner, en oppdatert kunnskapsbase og et testsett. Finetun først når dere kan vise hva som ikke fungerer godt nok i den enklere løsningen.