Du ber AI om å gjøre en jobb. Den svarer. Du oppdager en feil, gir ny beskjed og prøver igjen. Det er allerede en enkel sløyfe — men du er både prosjektleder, utfører og kvalitetskontrollør.
Loop Engineering er ideen om å designe denne prosessen mer bevisst. I stedet for å håpe at én god prompt gir perfekt resultat, lar du AI-en arbeide mot et tydelig mål, sjekke resultatet, bruke funnene til å forbedre neste forsøk og stoppe når den enten er ferdig eller trenger et menneske.
Det høres teknisk ut. Men den grunnleggende tanken er ganske hverdagslig: Gjør litt. Sjekk. Rett. Gjenta. Forskjellen er at en AI-agent kan gjøre flere av rundene selv — innenfor rammer du har bestemt. [1]
Fra «skriv dette» til en arbeidsflyt som kan lære av resultatet
En vanlig chat med Claude, ChatGPT eller en annen modell er ofte et enkelt spørsmål og et enkelt svar. Det fungerer godt for utkast, oppsummeringer og idéer. Men når oppgaven har flere steg og et tydelig krav til kvalitet, trenger AI-en mer enn en instruksjon.
En god sløyfe har vanligvis fem deler:
- Et avgrenset mål. Hva skal være sant når oppgaven er ferdig?
- Relevant kontekst. Hvilke filer, regler, eksempler eller systemdata trenger agenten?
- En handling. Hva får agenten faktisk lov til å gjøre?
- En observasjon. Hvordan ser den om resultatet virker — test, logg, sjekkliste, skjermbilde eller en annen kontroll?
- En stoppregel. Når skal den levere, når skal den prøve én gang til, og når må den spørre et menneske?
Dette er grunnen til at Loop Engineering er noe annet enn bare prompt engineering. En god prompt hjelper AI-en i gang. En god sløyfe gjør at den kan oppdage når første forsøk ikke er godt nok. [1]
Fra mål til lukket loop: Det som hindrer at agenten driver av gårde
Infografikken du delte beskriver et nyttig skille. En vanlig chat kan bli en kjede med prompt → respons: du gir hvert neste steg, holder konteksten sammen selv og stopper når du går tom for tid. En mer selvstendig arbeidsflyt begynner i stedet med mål → loop → resultat: agenten skal planlegge, utføre et avgrenset steg, kontrollere resultatet og enten prøve igjen eller levere videre.
Det betyr ikke at AI-en skal jobbe uendelig «mens du sover». Den viktige forskjellen er en lukket loop med en tydelig målbeskrivelse, en kontrollbar mengde kontekst, et kvalitetskriterium, budsjettgrenser og en stoppregel. Uten dem får du en åpen loop som kan bruke mye tid og tokens på å lete i feil retning.
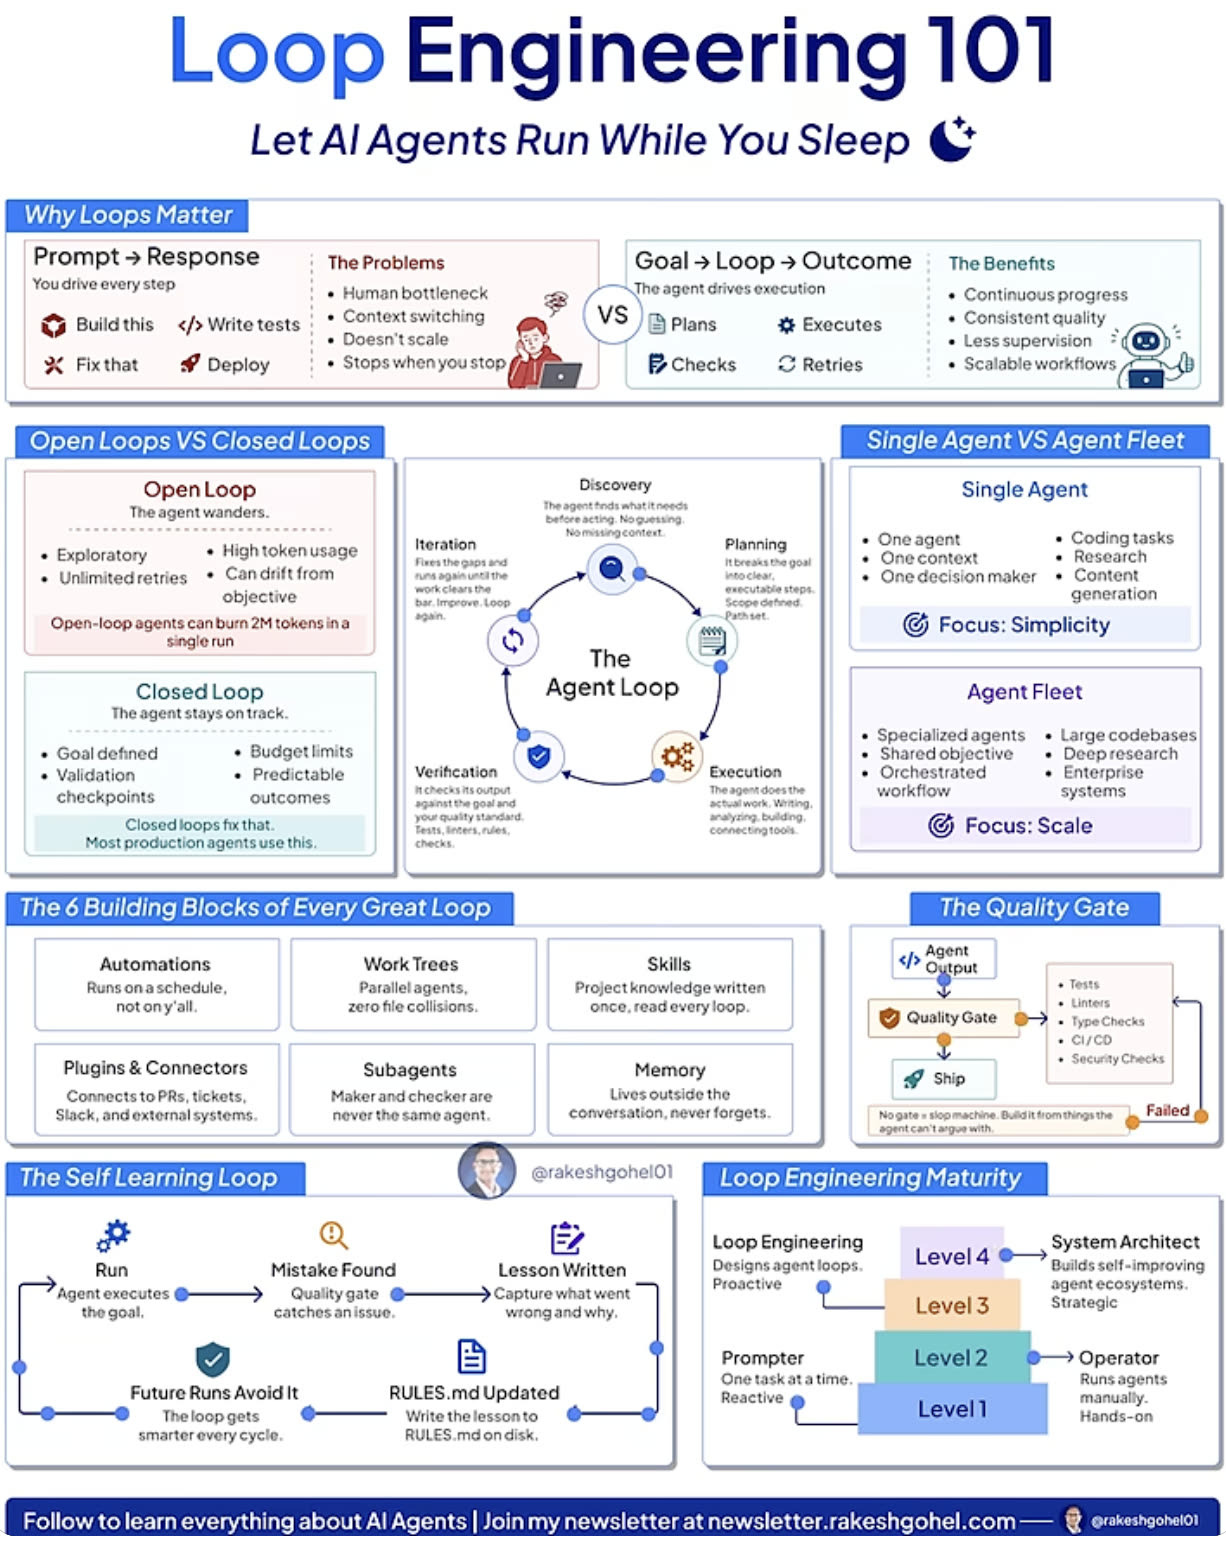
Skisse fra Loop Engineering 101-shortsen til Rakesh Gohel. Dette er et tredjepartseksempel og en pedagogisk modell — ikke dokumentasjon på at alle agentplattformer har de samme funksjonene. [2]
| Åpen loop | Lukket loop |
|---|---|
| Utforsker videre uten klart ferdigkriterium. | Har et tydelig mål, omfang og definisjon av «ferdig». |
| Kan være nyttig tidlig i research og idéarbeid. | Passer når arbeidet skal gjentas, testes eller leveres videre. |
| Kan bruke mye kapasitet og drive bort fra virksomhetens behov. | Har budsjett, maks antall forsøk, kvalitetssperre og stoppregel. |
| Mennesket må ofte rydde opp i retning og kontekst underveis. | Mennesket definerer rammer og godkjenner unntak eller risikable handlinger. |
Skal /goal være med?
Ja, ideen om et eksplisitt mål bør være med. Men /goal er ikke en universell kommando som finnes i Claude, OpenClaw, Hermes eller alle andre verktøy. I demonstrasjonen er det en arbeidskonvensjon: Et mål settes før agenten får bygge eller delegere. I deres oppsett kan det like gjerne være et felt i en oppgavetavle, en fil som heter GOAL.md, eller en kort måltekst i starten av et arbeidskort.
Et godt mål trenger ikke være langt. Det bør svare på fem ting:
- Utfall: Hva skal være sant når oppgaven er ferdig?
- Avgrensning: Hvilke kilder, mapper, systemer og verktøy er innenfor — og utenfor?
- Kvalitet: Hvilken test, sjekkliste eller fagperson avgjør om resultatet holder?
- Rammer: Hva er maksimal tid, kostnad og antall forsøk?
- Stopp: Når skal agenten levere, spørre eller stoppe helt?
Denne målbeskrivelsen er broen fra en smart demo til et praktisk harness. Den bør kobles til 4D-rammeverket: Delegering avklarer om oppgaven passer for AI, Beskrivelse gir kilder og rammer, Dømmekraft definerer kontrollen, og Aktsomhet bestemmer stoppe- og varslingsregler.
Seks byggesteiner — og hva som er viktigst først
Infografikken peker på automasjoner, work trees, skills, plugins/connectors, subagents og minne. Alle kan være nyttige, men de bør ikke introduseres samtidig.
| Byggestein | En nøktern bruk |
|---|---|
| Mål og plan | Start med et konkret arbeidskort eller GOAL.md før dere velger flere agenter. |
| Skills og minne | Legg godkjente eksempler, definisjoner og kvalitetsregler i lesbare Markdown-filer. Se Anti-Trendslop-skillen. |
| Verktøy og connectors | Koble bare til det agenten trenger for det konkrete arbeidskortet. Se MCP og Connectors. |
| Kvalitetssperre | Kjør test, lint, typekontroll, policy-sjekk eller menneskelig review før et resultat går videre. |
| Subagenter og work trees | Bruk først når oppgaven er stor nok til å trenge tydelig deling og isolerte endringer. |
| Automatisering | Planlegg repetisjon først etter at én manuell, målbar loop har fungert. |
En lærende loop kan gjerne registrere at en test feilet, foreslå en endring i en regel eller skrive en kandidat til RULES.md. Men den bør ikke selv få endre testfasit, godkjenningskrav eller produksjonstilgang. Endringer i slike styringsfiler skal behandles som forslag og gjennomgås på samme måte som kodeendringer.
Et jordnært eksempel: Nye kundehenvendelser
Tenk på en bedrift som får henvendelser fra kontaktskjema, e-post og Facebook. I stedet for å be AI-en «ta hånd om alt», kan du bygge en trygg, liten sløyfe:
- Samle nye henvendelser én gang i timen.
- Foreslå kategori, hastighet og hvem som bør følge opp.
- Skriv et kort svarutkast basert på bedriftens tone og informasjon.
- Sjekk at utkastet ikke lover pris, leveringstid eller rabatter som ikke er godkjent.
- Send det til et menneske for godkjenning — eller lever bare en prioritert oppgaveliste.
Her er målet ikke å erstatte kundebehandleren. Målet er å fjerne venting, kopiering og «den henvendelsen skulle jeg ha sett i går». Det ligner på tanken bak AI-resepsjonist og bookingflyter: den beste automatiseringen er ofte den som gjør én overlevering tryggere og raskere.
Gauntlet Loops: Når én AI bygger og en annen er beinhard kvalitetskontroll
Gauntlet Loop er et nyere, uformelt navn på en mye hardere variant av evaluator–optimizer-mønsteret. I videoen du delte, vises et oppsett der byggeagenter lager et resultat, mens separate kritikeragenter vurderer det mot en spesifikk kvalitetsstandard og sender forbedringsinstrukser tilbake i flere runder. [2]
Det er ikke en offisiell knapp i Claude eller en garanti for toppresultat. Det er et designmønster. Den viktige ideen er at den som lager, ikke bør være eneste person som sier at jobben er bra nok. Anthropic beskriver selv et beslektet evaluator–optimizer-mønster: én modell produserer, en annen vurderer og gir tilbakemelding i en sløyfe. [3]
I en Gauntlet Loop kan du ha flere spesialiserte roller:
| Rolle | Oppgave |
|---|---|
| Bygger | Lager førsteversjon av kode, tekst, design eller analyse. |
| Kritiker | Leter etter mangler mot en tydelig standard. |
| Tester | Kjører faktiske tester, sjekker lenker, data eller brukerflyt. |
| Koordinator | Bestemmer hva som skal repareres først og når arbeidet skal stoppe. |
| Menneske | Godkjenner risikable, kostbare eller strategiske valg. |
Videoen viser hvordan slike sløyfer kan brukes til avanserte 3D- og frontend-demonstrasjoner. Det er imponerende, men budskapet for en liten bedrift er enklere: Ikke bruk en hard kvalitetsloop for å finne ut hva du vil. Bruk den for å forbedre noe du allerede har testet som førsteutkast.
Start derfor med en enkel prototype. Se om AI-en har forstått oppgaven. Først deretter legger du på kontroll, flere runder og et strengere kvalitetssignal. Ellers kan du ende med at systemet jobber lenge og dyrt med å perfeksjonere feil løsning.
Graph Engineering: Når én sløyfe ikke er nok
En enkelt sløyfe kan bli veldig flink til å optimere én ting. Det kan også bli problemet.
Hvis du ber en kundeservice-agent om å få ned svartiden, kan den begynne å sende korte svar raskt. Metrikken ser flott ut, men kundene blir kanskje mindre fornøyde. Hvis du ber en salgsagent om å lukke flest mulig saker, kan den prioritere enkle kunder framfor riktige kunder. Dette er et klassisk problem: Systemet optimaliserer målet du målte, ikke nødvendigvis det du egentlig mente med «bedre».
Graph Engineering er et nyttig perspektiv for neste nivå: I stedet for én sløyfe bygger du et lite nettverk av sløyfer som følger med på hverandre. En sløyfe jobber for fart. En annen sjekker kvalitet. En tredje kontrollerer om dataene fortsatt er riktige. Og et menneske eller en fast regel avgjør hva som aldri kan ofres. [4]
For kundehenvendelser kan et lite «graf»-oppsett se slik ut:
| Sløyfe | Hva den optimaliserer | Hva som holder den ærlig |
|---|---|---|
| Respons | Kortere tid før kunden får svar | Sjekk av kvalitet, tone og korrekt informasjon |
| Salg | Flere relevante oppfølginger | Måling av avbestillinger, klager og reell konvertering |
| Kvalitet | Færre feil i svarene | Tilfeldig menneskelig gjennomgang og kildekontroll |
| Kostnad | Mindre manuelt arbeid | Maksgrense for AI-bruk og tydelig stoppregel |
Dette er ikke et argument for at alle trenger et stort agentsystem. Det er et argument for å ikke stole blindt på én pen dashboard-metrikk. Når en AI-løsning blir viktig, bør du ha minst én uavhengig kontroll som kan fortelle deg når den er på vei feil.
Hvor passer MCP, prosesskartlegging og orkestrering inn?
Loop Engineering handler om måten arbeidet skjer på. MCP og Connectors handler om hvordan AI-en oppdager og bruker verktøy og systemer. Prosesskartlegging handler om å forstå oppgaven før du automatiserer den. Og AI-orkestrering handler om å gi ulike modeller og agenter riktige roller.
Du trenger ofte litt av alle fire:
- Kartlegg arbeidet før du automatiserer det.
- Koble bare til systemene agenten faktisk trenger.
- Gi den en liten, tydelig rolle.
- Definer hva som teller som et godt resultat.
- La test, kritikk eller menneskelig gjennomgang styre neste runde.
Fire regler før du starter
- Start smalt. Velg én oppgave som skjer ofte, har tydelig start og slutt, og ikke kan gjøre stor skade.
- Gjør kvalitet målbar. «Bra» er for uklart. Bruk en konkret sjekkliste, test eller før-og-etter-eksempel.
- Sett en grense. Bestem maksimum antall forsøk, tidsbruk og kostnad før en person må se på saken.
- Behold en forankring i virkeligheten. Se på faktiske kundeutfall, utførte tester, reelle salg eller riktig regnskap — ikke bare en AI-generert rapport om at alt gikk bra.
En nyttig AI-sløyfe er ikke den som får lov til å jobbe lengst. Det er den som kan vise hva den gjorde, hvorfor den stoppet og hvordan den vet at resultatet holder.
Vil dere finne ut hvilken oppgave som egner seg som en trygg første sløyfe? Vi kan hjelpe med AI-strategi, prosesskartlegging og en pilot med tydelige kontrollpunkter. Ta en uforpliktende prat.
En loop bør bygges på et arbeidsmiljø som allerede har tydelig kontekst, lagret fremdrift og reelle kontroller. Harness Engineering fra grunnen av forklarer dette grunnlaget før dere automatiserer neste runde.
Kilder
[1] IBM — What is loop engineering?
[2] YouTube — Gauntlet Loop-eksempler og forklaring
[3] Anthropic Claude Cookbook — Evaluator–Optimizer
[4] Intuition Machine — From Loop Engineering to Graph Engineering?