Aleph Alpha har lansert Kolibri 1, en åpen modell med et tydelig europeisk og særlig tysk/engelsk fokus. Den er interessant av flere grunner: Den har 78 milliarder parametere totalt, aktiverer bare rundt 3,46 milliarder per token, støtter verktøykall og kan håndtere svært lange dokumenter.
Men dette er ikke en liten modell du laster ned til en vanlig kontor-PC. Kolibri 1 er laget for servere med mye GPU-minne. For norske bedrifter er derfor spørsmålet ikke bare «er modellen god?», men også «har vi et reelt behov for å drifte en så stor modell selv?».
Først: hva er Kolibri 1?
Kolibri 1 er en mixture-of-experts-modell, ofte forkortet MoE. I en vanlig modell brukes alle delene av modellen på hver beregning. I en MoE-modell finnes det flere ekspertmoduler, og en ruter velger hvilke eksperter som skal brukes for hvert token.
Kolibri har ifølge det offisielle modellkortet rundt 78,1 milliarder parametere totalt, men bare 3,46 milliarder aktive parametere per token. Det betyr at hver enkelt beregning kan bli lettere enn tallet «78 milliarder» først får det til å høres ut som.
Samtidig må den samlede vektmengden fortsatt være tilgjengelig i minnet på serveroppsettet, selv om den kan fordeles over flere GPU-er. MoE gjør altså ikke automatisk en stor modell liten. Det kan redusere beregningsmengden per token, men minnebehovet er fremdeles høyt.
Tysk og engelsk først
Kolibri er utviklet med hovedvekt på tysk og engelsk. Det er en bevisst prioritering, ikke en modell som prøver å være like god på alle verdens språk.
Dette kan være interessant for virksomheter som jobber med:
- tyske kunder, leverandører eller konsern
- teknisk dokumentasjon på tysk og engelsk
- europeisk forskning og industrisamarbeid
- interne kunnskapsbaser med lange dokumenter
- agentarbeid der verktøy må kalles på en kontrollert måte
For en norsk bedrift bør man derimot teste norsk tekst selv. At en modell er sterk på tysk og engelsk betyr ikke automatisk at den skriver godt norsk, forstår lokale uttrykk eller behandler norske fagtekster riktig.
Opptil én million tokens – men med en viktig fotnote
Kolibri er validert med kontekst på opptil 1 048 576 tokens, altså omtrent én million tokens. Det er mye mer enn et vanlig chattevindu og kan i prinsippet romme svært store dokumentmengder.
Aleph Alpha anbefaler likevel å holde seg på eller under 262 144 tokens når man ønsker god effektivitet og komplekse oppgaver. Det er en viktig forskjell mellom «modellen kan ta imot én million tokens» og «det er alltid raskt, rimelig og smart å gi den én million tokens».
Lang kontekst løser heller ikke automatisk kunnskapsarbeid. En modell kan fortsatt overse et viktig avsnitt, blande sammen kilder eller trekke en feil konklusjon. For dokumentarbeid bør man derfor fortsatt bruke tydelig kildevisning, avgrensede oppgaver og menneskelig kontroll.
Reasoning og tool calling
Kolibri støtter en eksplisitt reasoning-modus, der modellen kan bruke mer arbeid på flertrinnsoppgaver. Den støtter også tool calling, slik at et system kan la modellen foreslå bruk av et API, søk eller et annet verktøy.
Det gjør modellen aktuell i agentiske arbeidsflyter, men det betyr ikke at den bør få handle fritt. Aleph Alpha beskriver selv Kolibri som egnet for systemer der en person vurderer resultatet før det blir gjennomført, og ikke som en komponent som tar beslutninger uten oppsyn. Hvis flere harnesser og agentroller skal samarbeide rundt slike oppgaver, viser OpenRig-artikkelen hvorfor modellvalg, rollefordeling og kontrollpunkter må skilles fra hverandre.
Et trygt eksempel kan være:
- Kolibri leser en samling tyske leverandørdokumenter.
- Den trekker ut frister, beløp og avvik.
- Den foreslår hvilke dokumenter som bør undersøkes nærmere.
- Et menneske kontrollerer kildene.
- Først etter godkjenning går eventuelle data videre til et økonomi- eller saksbehandlingssystem.
Hva viser benchmarkbildet?
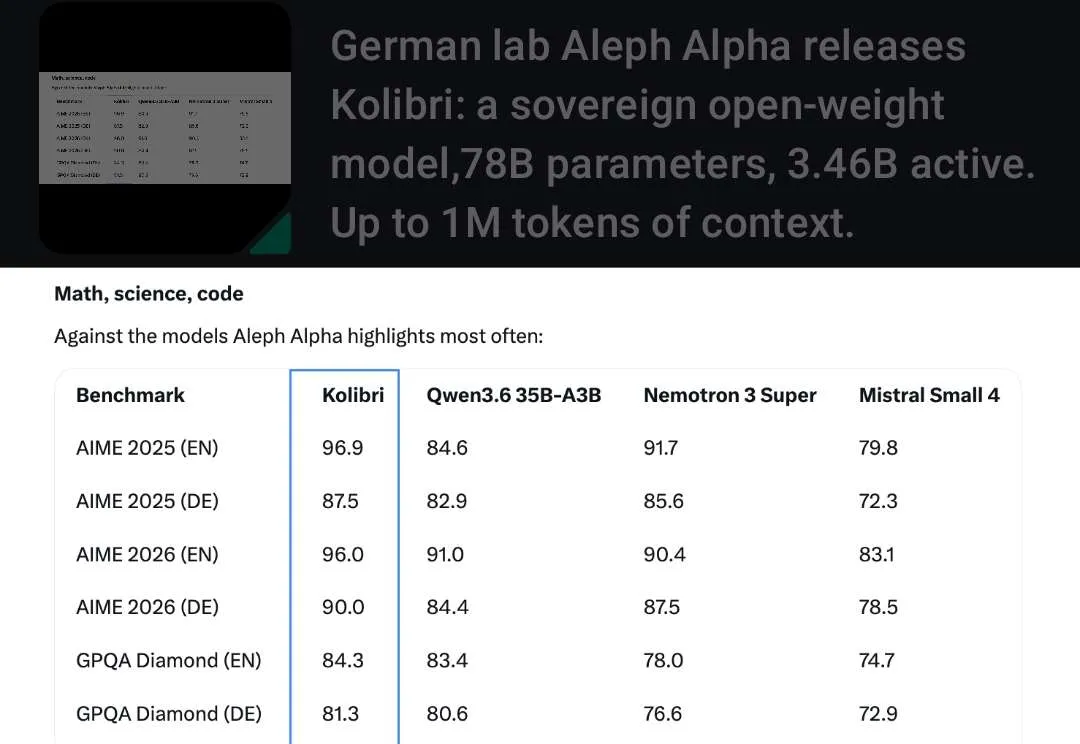
Bildet i artikkelen er hentet fra Kolibri 1-siden på Hugging Face, og viser et utvalg av sammenligninger mot modeller som Qwen, Nemotron og Mistral. Kolibri ser sterk ut på flere av testene Aleph Alpha fremhever, blant annet innen matematikk og vitenskap.
Slike tabeller er nyttige for å forstå hva leverandøren har testet, men de er ikke det samme som en uavhengig garanti for at modellen er best for deres arbeid. Resultatene avhenger av blant annet:
- hvilke modeller som sammenlignes
- hvilken prompt og evalueringsmetode som brukes
- om modellen får bruke reasoning-modus
- om verktøy og eksterne kilder er tilgjengelige
- om testen måler matematikk, kode, dokumentforståelse eller praktisk norsk tekst
Det offisielle modellkortet oppgir at Kolibri-resultatene er kjørt med høy reasoning-innsats i evalueringene. Det er relevant når man sammenligner både kvalitet, svartid og kostnad.
«Sovereign» betyr ikke automatisk at alt er lokalt og privat
Aleph Alpha omtaler Kolibri som en suveren, åpen modell. Det er en viktig diskusjon i Europa: Flere virksomheter og offentlige aktører ønsker mindre avhengighet av amerikanske skyleverandører og bedre kontroll over hvor data og modeller behandles.
Men begrepet må brukes presist. At vektene er åpne og lisensen er Apache 2.0 betyr ikke automatisk at en installasjon er sikker, GDPR-godkjent eller fri for leverandøravhengighet.
Dere må fortsatt vurdere:
- hvor modellen kjøres
- hvem som har tilgang til GPU-serveren
- hvilke logger som lagres
- om modellserveren har nettverkstilgang
- hvordan oppdateringer og sårbarheter håndteres
- om data sendes til eksterne verktøy gjennom tool calling
- hvem som har ansvar når modellen tar feil
Å kjøre modellen i et europeisk datasenter kan gi en annen kontrollprofil enn å bruke en tilfeldig skyplattform. Men «europeisk» er ikke det samme som «uten risiko».
Hvor mye maskinvare trenger Kolibri?
Det offisielle modellkortet oppgir en minnefotavtrykk på omtrent 78 GB for FP8-vektene. Minimumskonfigurasjoner som nevnes er blant annet to A100 80 GB, to H100 SXM5, én H200, én B200 eller én B300. Aleph Alpha anbefaler sterkere oppsett for god drift.
I praksis må man også regne med minne til KV-cache, runtime, parallellisering, operativsystem og andre prosesser. En GPU som akkurat har plass til vektene er ikke nødvendigvis en god produksjonsserver.
Det er derfor viktig å skille mellom:
| Scenario | Hva Kolibri 1 betyr |
|---|---|
| Vanlig kontor-PC eller MacBook | Ikke et realistisk standardvalg |
| Lokal AI på en kraftig arbeidsstasjon | Mulig bare med svært mye minne og riktig støtte; må testes nøye |
| Egen GPU-server | Teknisk mulig, men krever drift, sikkerhet og overvåking |
| Europeisk skytjeneste | Kan være mer praktisk enn å kjøpe og drifte maskinvare selv |
| Vanlig API-bruk | Ofte enklere hvis behovet er sporadisk og databehandlingen er akseptabel |
Kolibri er altså mer relevant i et planlagt servermiljø enn som «last ned og prøv»-modell for de fleste.
Hva kan en norsk bedrift bruke den til?
Hvis dere har riktig infrastruktur og et tydelig behov, kan Kolibri være interessant for:
- oppsummering og søk i store tyske eller engelske dokumentarkiv
- intern kunnskapsassistent med lange manualer og kontrakter
- førsteutkast til teknisk dokumentasjon
- strukturert uttrekk fra tilbud, kravspesifikasjoner og rapporter
- assistenter som foreslår API-kall eller arbeidssteg
- forskning og utvikling der data ikke bør sendes til en generell skytjeneste
I alle disse tilfellene bør modellen først være rådgiver. Den bør ikke alene godkjenne en betaling, tolke en kontrakt juridisk, endre ERP-data eller sende kundekommunikasjon uten kontroll.
For en vanlig norsk virksomhet kan en mindre modell, en ferdig europeisk AI-tjeneste eller en hybrid løsning gi bedre totaløkonomi. Artikkelen om offline AI og Tiiny forklarer forskjellen mellom mindre lokale modeller og tunge serverløsninger. Artikkelen om lokal AI-testpartner viser også hvorfor lokal kjøring krever mer enn bare å laste ned en modell.
Hvordan passer Kolibri inn i utviklingen?
Kolibri viser en retning som blir viktigere fremover: modeller blir ikke nødvendigvis best fordi de støtter flest språk eller har flest aktive parametere. En modell kan i stedet være svært god for en bestemt region, språkgruppe, dokumenttype eller arbeidsflyt.
MoE-arkitekturen viser også hvordan man prøver å kombinere stor samlet kapasitet med lavere beregning per token. Samtidig viser minnekravet begrensningen: Det er ikke nok å se på aktive parametere når man vurderer lokal drift.
Sammen med modeller som Qwen, lokale verktøy og bedre agentmiljøer kan dette gi virksomheter flere valgmuligheter. På infrastrukturnivå er DeepGEMM et eksempel på programvare som prøver å gjøre de tunge GPU-beregningene under slike modeller mer effektive. Men det gjør også modellvalg mer komplisert. Før dere velger, bør dere teste på egne dokumenter og egne språk – ikke bare på benchmarktabeller.
Konklusjon
Kolibri 1 er en interessant europeisk open-weight-modell for tysk og engelsk, med MoE-arkitektur, reasoning, tool calling og svært lang kontekst. Den kan være aktuell for dokumenttunge og agentiske arbeidsflyter der kontroll over modell og data er viktig.
Den er samtidig ikke en lett lokal modell. Med rundt 78 GB vekter i FP8 og krav om kraftig GPU-infrastruktur bør de fleste bedrifter starte med en behovsanalyse før de vurderer egen drift.
Den riktige lærdommen er ikke at alle bør kjøre Kolibri. Det er at modellvalg bør baseres på språk, data, personvern, arbeidsflyt, kostnad og kontroll – ikke bare på hvor imponerende tallet på parametere ser ut.