Når vi snakker om AI, handler samtalen ofte om hvilken modell som er smartest. Men under modellen finnes et annet lag: selve regnearbeidet. Store mengder matriseberegninger må flyttes gjennom GPU-en så raskt og effektivt som mulig.
DeepGEMM er et åpen kildekode-prosjekt fra DeepSeek som arbeider nettopp på dette laget. Det er ikke en chatbot, ikke en ny språkmodell og ikke noe du installerer på en vanlig kontor-PC for å få bedre svar i Claude. Det er et bibliotek med spesialiserte GPU-kjerner som kan gjøre sentrale beregninger i moderne AI-systemer raskere.
DeepGEMM er ikke et rabattkort for Claude eller ChatGPT
Påstander om at DeepGEMM «sparer 98 prosent på tokens» eller gjør en bestemt API-regning om fra for eksempel 50 til 1,60 dollar, blander tre ulike ting: antall tokens en modell bruker, hvor mange tokens en GPU kan produsere i sekundet, og prisen en API-leverandør tar per token.
DeepGEMM reduserer ikke antall input- eller output-tokens modellen bruker. Det kan i beste fall øke gjennomstrømningen på kompatibel, egenstyrt GPU-infrastruktur. Når samme GPU kan gjøre flere relevante beregninger per sekund, kan den delen av kostnaden som gjelder GPU-tid per genererte token bli lavere. Hvor mye avhenger av modell, matriseformer, batch-størrelse, GPU-type, minne, nettverk og resten av inferenssystemet.
Det kan ikke installeres «inne i» en Claude-, ChatGPT- eller annen lukket API-tjeneste. Der bestemmer leverandøren både maskinvare, kjernene under modellen og prislisten. For en API-kunde endres derfor ikke tokenprisen fordi DeepGEMM finnes som åpen kildekode.
DeepSeek sin egen dokumentasjon beskriver høy ytelse på utvalgte beregninger og at biblioteket kan matche eller slå ekspertoptimaliserte biblioteker for ulike matriseformer. Den dokumenterer ikke en generell besparelse på 98 prosent eller en universell sammenligning som «1,60 i stedet for 50 dollar». En seriøs kostnadssammenligning må oppgi modell, antall og lengde på forespørsler, batch, GPU-er, skyregion, utnyttelsesgrad, drift og kvalitetstester.
| Situasjon | Hva DeepGEMM kan bety |
|---|---|
| Du bruker Claude eller ChatGPT via abonnement eller API | Ingen direkte endring i tokenpris eller tokenforbruk. |
| Du drifter en kompatibel åpen modell på egne eller leide NVIDIA-GPU-er | Kan være en del av et teknisk arbeid for bedre gjennomstrømning og lavere GPU-tid per token. |
| Du har én enkelt GPU eller liten modellserver | Gevinsten må måles mot integrasjonsarbeid, stabilitet og andre flaskehalser. Et nytt GPU-bibliotek er ikke automatisk det viktigste tiltaket. |
Det mest presise er derfor å si: DeepGEMM kan gjøre egne, kompatible AI-servere mer effektive. Det kan over tid bidra til lavere regnekostnad per token, men det er ikke det samme som færre tokens eller billigere tilgang til lukkede AI-API-er.
Kort forklart: hva er en GEMM?
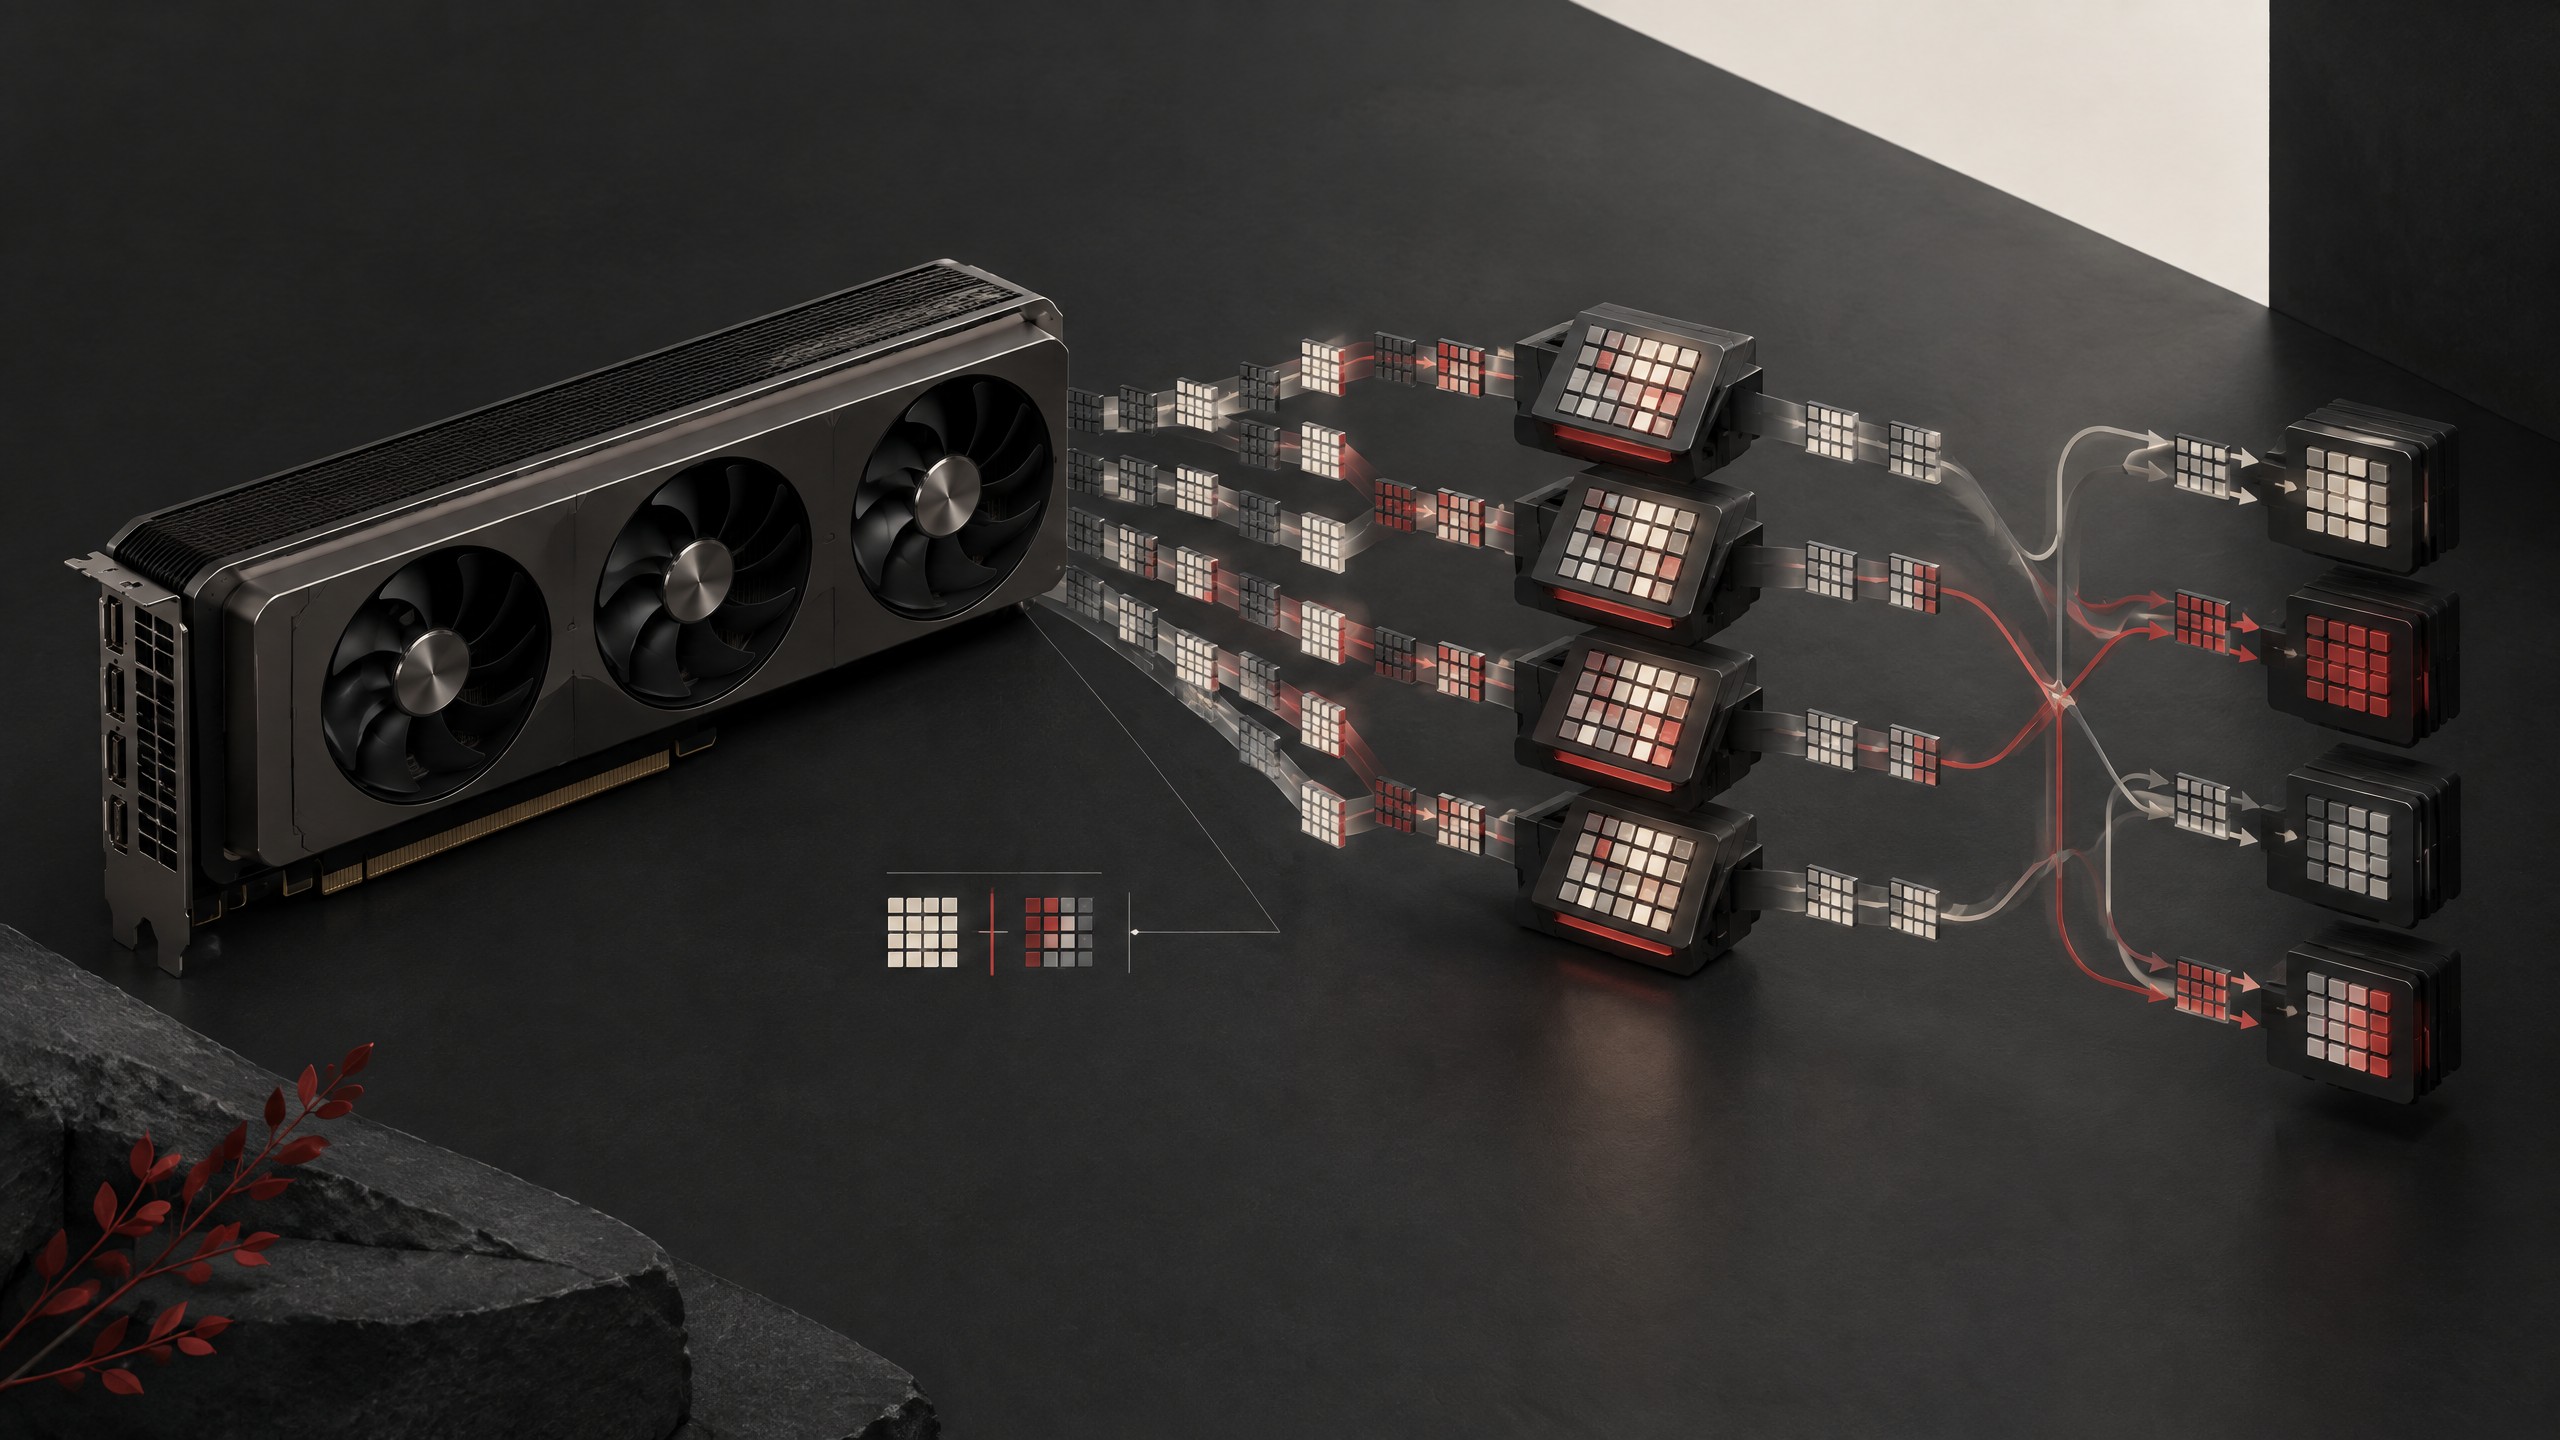
GEMM står for «general matrix multiplication» – generell matrise-multiplikasjon. Det høres matematisk ut, men ideen er enkel: AI-modeller gjør enorme mengder beregninger der tall i tabeller kombineres med hverandre.
Når en språkmodell leser tekst, lager en prognose eller velger hvilke deler av et såkalt mixture-of-experts-system som skal brukes, skjer mye av arbeidet som matriseberegninger. En GEMM-kjerne er den delen av programvaren som utfører dette arbeidet på GPU-en.
En dårlig tilpasset kjerne kan la regnekraft stå ubrukt. En godt optimalisert kjerne kan utnytte tensor-kjernene bedre, flytte mindre data unødvendig og overlappe beregning med kommunikasjon mellom GPU-er. Forskjellen merkes først og fremst når systemet gjør svært mange beregninger – for eksempel under trening eller når en AI-tjeneste svarer mange brukere samtidig.
Hva gjør DeepGEMM?
DeepGEMM samler flere slike optimaliserte byggesteiner i én CUDA-basert kodebase. Ifølge prosjektets egen dokumentasjon støtter biblioteket blant annet:
- FP8-, FP4- og BF16-beregninger – tallformater som kan redusere minnebruk og øke gjennomstrømningen når de brukes riktig.
- Vanlige og grupperte GEMM-beregninger – grupperte varianter er spesielt interessante for mixture-of-experts-modeller.
- Mega MoE – en sammenslått arbeidsflyt som kan kombinere ekspertvalg, lineære lag, aktivering og kommunikasjon mellom GPU-er.
- Kjerner for en såkalt lightning indexer – en del av nyere DeepSeek-arkitektur som scorer hvilke deler av konteksten som er relevante.
- DeepJIT – prosjektets løsning for å kompilere kjernene ved behov, slik at installasjonen ikke trenger å kompilere all CUDA-kode på forhånd.
Poenget er ikke at én funksjon magisk gjør all AI raskere. Poenget er å optimalisere de delene av regnejobben som gjentas millioner eller milliarder av ganger.
Hvorfor FP8 og FP4 er interessant
En AI-modell trenger ikke alltid å lagre alle tall med samme presisjon. I enkelte beregninger kan et mindre tallformat være tilstrekkelig. FP8 og FP4 bruker færre bits enn for eksempel FP16 eller BF16, og kan derfor redusere hvor mye data som må flyttes og lagres.
Men lavere presisjon er ikke gratis. Skal det fungere, må skalaer, avrunding, minneoppsett og selve modellen håndteres riktig. Feil bruk kan påvirke kvaliteten eller gi ustabile resultater. DeepGEMM optimaliserer de matematiske kjernene, men prosjektets egen README gjør det tydelig at brukeren fortsatt må håndtere ting som transponering av input og konvertering til FP8 selv.
Det er en viktig forskjell mellom «et bibliotek støtter FP8» og «hele AI-systemet er klart for FP8». I praksis må hele arbeidsflyten testes: modell, maskinvare, minne, kommunikasjonslag og måling av kvalitet.
Hvor passer mixture-of-experts inn?
Mange nyere språkmodeller er bygget som mixture of experts, ofte forkortet MoE. I stedet for at alle delene av en stor modell brukes for hvert token, velges noen eksperter for den aktuelle oppgaven.
Det kan gi mer kapasitet uten at alle parametere må aktiveres hver gang. Samtidig blir infrastrukturen mer krevende. Tokenene må fordeles til riktige eksperter, beregningene må gjøres, og resultatene må samles igjen – ofte på tvers av flere GPU-er.
DeepGEMM forsøker å samle mer av dette i effektive operasjoner og samtidig overlappe kommunikasjon med beregning. Det er særlig relevant for store servermiljøer, der nettverk mellom GPU-er og GPU-minne kan være like viktig som rå regnekraft. Kolibri 1 er et konkret eksempel på hvorfor dette er relevant: En MoE-modell kan aktivere en liten del av modellen per token, men den trenger fortsatt en infrastruktur som håndterer hele modellens vektmengde, minne og kommunikasjon.
Hva betyr «1550 TFLOPS»?
DeepSeek oppgir at DeepGEMM i en tidligere prosjektoppdatering nådde opptil 1550 TFLOPS på H800 i bestemte tester. Det er et interessant tall, men det bør leses som et leverandør- og prosjektspesifikt benchmarkresultat – ikke som en garanti for alle modeller eller alle arbeidslaster.
Ytelsen avhenger blant annet av:
- størrelsen og formen på matrisene
- om beregningen er tett eller gruppert
- tallformat og skaleringsmetode
- hvor mye data som må flyttes mellom GPU-er
- hvilken CUDA-versjon og driver som brukes
- om resten av systemet klarer å levere data raskt nok
En benchmark på én GPU og én matriseform sier derfor ikke automatisk hvor raskt en komplett språkmodell vil svare i produksjon. Det er total arbeidsflyt, stabilitet, kostnad per forespørsel og kvalitet som må måles.
Kan en vanlig bedrift bruke DeepGEMM?
For de fleste små og mellomstore bedrifter på Sunnmøre er svaret: ikke direkte – og det er helt greit.
DeepGEMM krever ifølge prosjektets dokumentasjon blant annet:
- NVIDIA-GPU med SM90- eller SM100-arkitektur
- CUDA Toolkit 12.9 eller nyere
- PyTorch 2.3 eller nyere
- CUTLASS 4.0 eller nyere
- kompilatorer og standardbibliotek med C++20-støtte
Dette peker mot tunge AI-servere og utviklingsmiljøer, ikke en vanlig arbeidsstasjon eller en liten lokal LLM på en MacBook. Om dere bare vil bruke en AI-assistent, analysere dokumenter eller lage en intern kunnskapsløsning, er det normalt mer relevant å velge en god modell, et trygt verktøy og en ryddig arbeidsflyt.
En ny NVIDIA-PC er ikke automatisk kompatibel
Det er fristende å se en ny Blackwell-basert RTX 5090 eller RTX Pro 6000 og anta at «Blackwell» betyr at hele DeepGEMM-stakken fungerer. DeepSeek sin README oppgir SM90 og SM100 som støttede arkitekturer. En offentlig DeepSeek-sak dokumenterer at enkelte DeepSeek-V4-kjerner manglet SM120-støtte på RTX 5090 og RTX Pro 6000 Blackwell i april 2026. Vedlikeholderen viste til en referanseimplementasjon fra fellesskapet, men skrev samtidig at prosjektet ikke selv planla å vedlikeholde SM120 på grunn av manglende maskinvare og kapasitet. [2]
Poenget er ikke at slike kort er ubrukelige. Poenget er at dere må teste den konkrete modellen, inferensmotoren og kernelbanen før dere kjøper maskinvare eller lover kapasitet. «Ny NVIDIA-GPU» er ikke en fullstendig kompatibilitetsplan.
Det DeepGEMM likevel viser, er hvor viktig infrastrukturen bak AI har blitt. Når modeller blir større og flere bedrifter ønsker lokal eller privat kjøring, blir GPU-minne, databevegelse, tallformater og kostnad per beregning viktigere enn bare antall parametere.
Les også artikkelen om offline AI og Tiiny hvis du vil se forskjellen mellom en liten lokal løsning og infrastrukturen som trengs for store AI-modeller. Kolibri 1 viser hvordan MoE-arkitektur kan gjøre dette relevant på modellnivå. For hvordan modeller, verktøy og kontrollpunkter kan settes sammen i en arbeidsflyt, se artikkelen om AI-orkestrering.
Hva bør du følge med på fremover?
DeepGEMM er relevant å følge med på av tre grunner.
For det første viser prosjektet at konkurransen mellom AI-leverandører ikke bare foregår på modellnivå. Den foregår også i kompilatorer, GPU-kjerner, minneoppsett og kommunikasjon mellom maskiner.
For det andre kan bedre optimalisering gjøre det mulig å kjøre større modeller med samme maskinvare – eller samme arbeidsmengde med lavere strøm- og serverkostnad. Det kan over tid gjøre lokal og privat AI mer tilgjengelig, selv om DeepGEMM i seg selv ikke gjør en liten bedrift klar for dette.
For det tredje viser prosjektet at åpen kildekode kan gi flere miljøer innsikt i hvordan moderne AI-infrastruktur bygges. DeepGEMM er MIT-lisensiert, men det betyr ikke at installasjon, drift og bruk er uten kostnad. Du trenger fortsatt kompatibel maskinvare, utviklerkompetanse, overvåking og en plan for oppgraderinger.
Konklusjon: viktig infrastruktur, ikke en ny kontorapp
DeepGEMM er et godt eksempel på den delen av AI-utviklingen som sjelden synes for brukeren. Det handler ikke om en ny chatbot med en morsom funksjon, men om å gjøre de tunge regneoperasjonene under moderne modeller mer effektive.
For en vanlig bedrift er den praktiske lærdommen ikke at dere bør installere DeepGEMM i morgen. Den er at AI-kostnad og -hastighet etter hvert vil avgjøres av hele kjeden: modell, tallformat, maskinvare, minne, nettverk og programvare.
Start derfor med behovet, ikke med GPU-biblioteket. Hvis dere trenger en intern assistent, bør dere først kartlegge data, tilgang, personvern, arbeidsflyt og forventet gevinst. Når behovet blir stort nok til å drifte egne GPU-er eller mange modellkall, kan teknologier som DeepGEMM bli en del av infrastrukturen under løsningen.
Kilder
[1] DeepGEMM på GitHub — DeepSeek
[2] DeepSeek Issue #317 — manglende SM120-kjerner for DeepSeek-V4
[3] Agentpedia Codes — DeepGEMM Guide: FP8-kjerner, Mega MoE og Hopper/Blackwell — en teknisk fordypning for utviklere; den bygger på README, pull requests og issues, og oppgir at forfatteren ikke selv har kjørt hele benchmark-suiten.