Mange AI-prosjekter starter med én fil, én prompt og en demo som ser lovende ut. Det kan være riktig i starten. Men når løsningen skal lese ekte dokumenter, håndtere kundedata og levere stabile svar hver dag, trenger dere mer enn en modell. Dere trenger en produksjonsarkitektur.
Se for deg en intern assistent som skal finne tidligere tilbud, ordre eller kundesaker og gi et kildebasert svar. Den må finne riktig dokument, forstå hva den har lov til å lese, vise hva den bygger på og varsle når resultatet er usikkert. De ni lagene nedenfor er en måte å fordele disse ansvarene på.
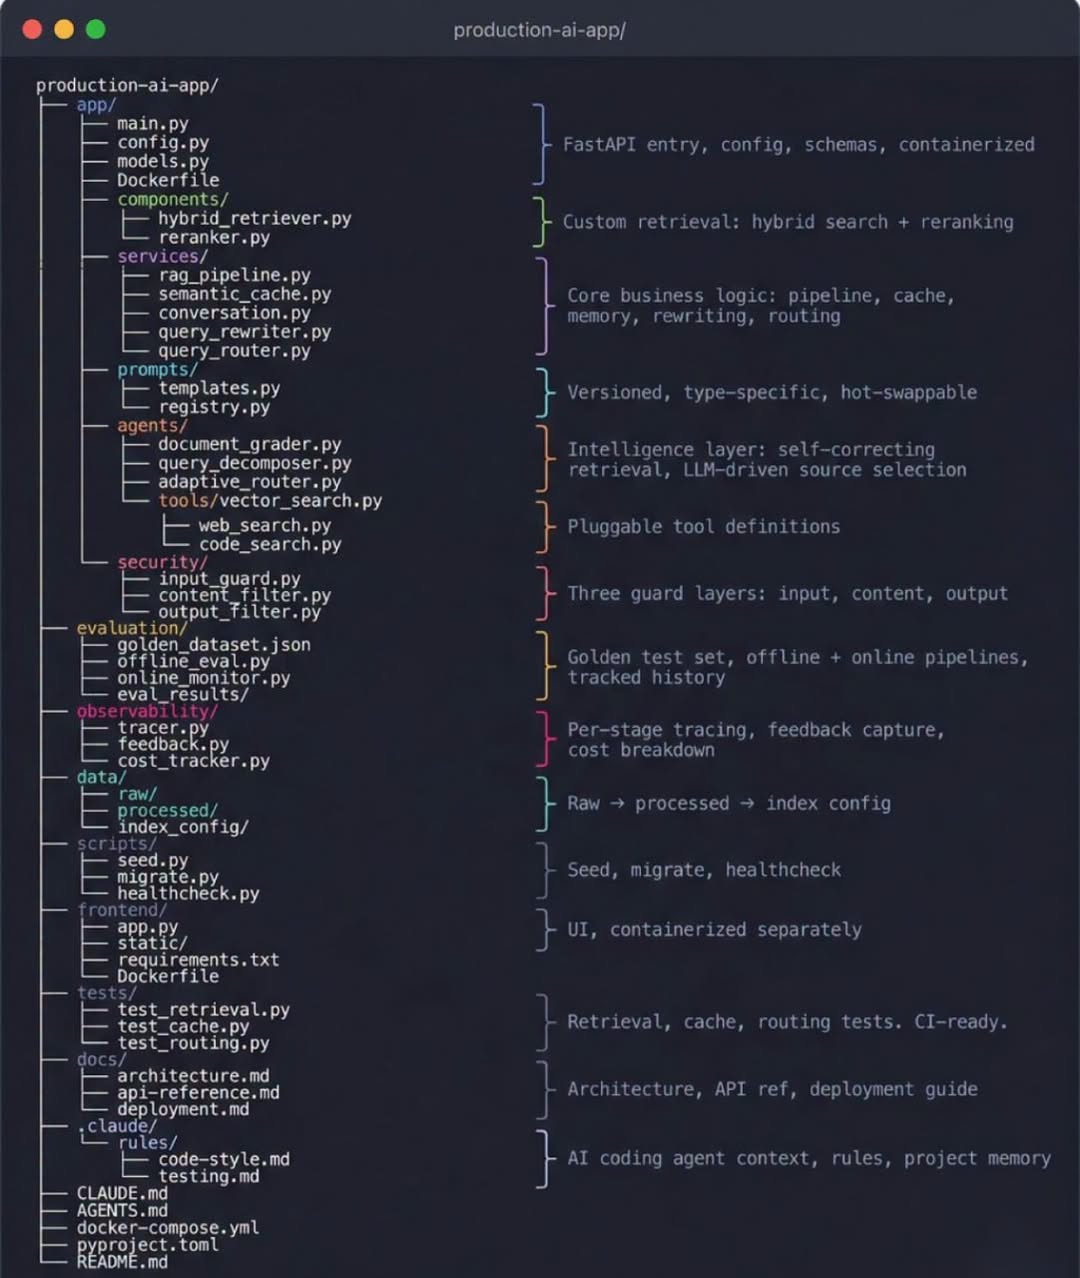
Illustrasjonen nedenfor viser en praktisk måte å dele opp en AI-løsning på. Poenget er ikke at alle små bedrifter må bygge alle delene fra dag én. Poenget er å vite hvilke ansvar som må finnes når løsningen vokser.
TL;DR: Hva er poenget?
En AI-demo kan fungere med én modell og én prompt. En løsning som skal brukes over tid trenger i tillegg tydelig dokumenthenting, routing, sikkerhet, evaluering og logging. De ni lagene er en sjekkliste for å se hva som mangler før dere gir systemet ekte data eller lar det gjøre handlinger på egen hånd.
Dere trenger ikke bygge alle lagene samtidig. Start med én avgrenset og reverserbar oppgave. Legg til mer struktur når dere får mer volum, høyere risiko eller flere modeller og verktøy i samme arbeidsflyt.
De ni lagene kort forklart
!Ni lag i en AI-produksjonsarkitektur
1. App og grunnmur
Her ligger inngangspunktet til løsningen: API-et, konfigurasjonen, datamodellene og måten systemet pakkes og kjøres på. I illustrasjonen er dette `app/` med blant annet en FastAPI-inngang, konfigurasjon, modeller og Dockerfile.
Dette laget bør svare på et enkelt spørsmål: Hvordan kjører vi tjenesten likt i utvikling, test og produksjon? Uten en ryddig grunnmur blir det vanskelig å vite om en feil kommer fra modellen, koden eller miljøet rundt.
2. Components: henting og rangering
Et AI-svar blir ikke bedre enn informasjonen som sendes inn. `components/` kan derfor inneholde egen logikk for hybrid søk, dokumenthenting og rerangering.
En RAG-løsning henter relevante dokumenter før modellen svarer. Hybrid søk kombinerer vanlig tekstsøk med semantisk søk, altså søk etter mening. Rerangering betyr at treffene vurderes på nytt før de sendes til modellen. Dette er viktig fordi feil dokument i konteksten kan gi et overbevisende, men galt svar.
3. Services: selve arbeidsflyten
Services-laget bør ikke være én stor fil. Det kan deles opp i tydelige tjenester for:
- RAG-pipeline og dokumentflyt
- semantisk cache, slik at like spørsmål ikke må regnes ut på nytt
- minne og samtalekontekst
- omskriving av uklare spørsmål
- routing til riktig modell eller behandlingsløp
Dette er ofte forskjellen på en demo og en løsning som kan vedlikeholdes. Når routing, minne og dokumenthenting ligger hver for seg, kan dere teste og bytte én del uten å rive ned alt.
Les mer om AI-routing og hvordan flere modeller kan brukes uten kaos.
4. Prompts som versjonert kode
Prompts bør ikke være gjemt som lange tekststrenger inne i Python-filer. I `prompts/` kan de registreres, versjoneres og knyttes til en bestemt oppgavetype.
Da kan dere se hvilken instruksjon som ga et bestemt resultat. Dere kan også teste en ny versjon mot et kjent datasett før den tas i bruk. Det gjør prompten mer lik annen programkode: Den har en eier, en historikk og en måte å rulle tilbake på.
5. Agents: oppgaver med kontroll
Agentlaget gir løsningen mer arbeidsdeling. En dokumentgransker kan vurdere om kildene er gode nok. En decomposer kan dele et stort spørsmål opp i mindre oppgaver. En adaptiv router kan velge neste steg basert på hva som allerede er funnet.
Dette betyr ikke at dere bør lage mange agenter med en gang. Flere roller gir også flere feilkilder. Start med én tydelig oppgave og legg først til en ny agent når dere kan forklare hva den gjør bedre enn en vanlig funksjon.
6. Tools: begrensede verktøy
Agenter trenger ofte søk, dokumentlesing eller andre verktøy. De bør beskrives separat og ha tydelige grenser. Et søkeverktøy bør for eksempel ikke automatisk kunne endre CRM-data bare fordi agenten har tilgang til det.
Et godt verktøylag gjør det mulig å se hvilke handlinger som er tilgjengelige, hvilke argumenter som er tillatt og hvilke handlinger som krever godkjenning. Tilgang bør gis etter behov, ikke etter hva som er enklest å koble til.
7. Security: tre vakter, ikke én
Sikkerhet bør ikke legges til som en siste filterfunksjon. Illustrasjonen deler den i tre:
- Input guard: Stopper eller renser uventede forespørsler før de sendes videre.
- Content filter: Vurderer dokumenter og innhold som hentes inn.
- Output filter: Kontrollerer svaret før det vises, lagres eller brukes til en handling.
I tillegg kommer tilgangsstyring, logging, sletting og menneskelig godkjenning. Et filter alene beskytter ikke mot feil tilgang eller en agent som får for vide fullmakter.
8. Evaluation: test før dere stoler på resultatet
Evalueringslaget er ofte det som mangler når en demo blir satt i drift. Lag et lite golden dataset: en fast samling representative spørsmål, dokumenter og forventede resultater. Kjør det gjennom løsningen etter endringer.
Det bør finnes både offline-evaluering og online-overvåking. Offline-testen oppdager at en ny prompt eller modell gjør resultatene svakere før lansering. Online-monitoren viser hva som skjer med virkelige forespørsler etterpå.
For en sorteringsløsning kan dere måle riktig kategori, usikkerhet og hvor ofte en medarbeider må korrigere. For en dokumentassistent kan dere måle kildebruk, manglende svar og om svaret holder seg innenfor avtalte regler.
9. Observability: se hva som faktisk skjer
Observability betyr at dere kan følge en forespørsel gjennom systemet, steg for steg. Hvor lang tid brukte dokumenthentingen? Hvilken modell ble valgt? Hvor mange tokens og kroner kostet kjøringen? Hvilket steg førte til at en medarbeider korrigerte resultatet?
Per-steg-sporing koblet til tilbakemeldinger gjør feilene lettere å forbedre. Kostnad per forespørsel gjør det mulig å se om en billig modell faktisk sparer penger, eller om ekstra kontrollarbeid spiser opp gevinsten.
Hvorfor «ikke én fil» er et viktig poeng
En enkelt fil kan være fint for å teste en idé. Men når alt ligger samlet, blir det vanskelig å svare på grunnleggende spørsmål:
- Hvilken prompt brukte systemet?
- Hvor kom dokumentet fra?
- Hvilken modell tok avgjørelsen?
- Hvilken sikkerhetskontroll stoppet eller slapp gjennom svaret?
- Hvorfor ble kostnaden høyere denne uken?
- Hvilken endring gjorde resultatet svakere?
Når ansvaret er delt i lag, blir det mulig å finne svaret. Det betyr ikke at koden må bli tung eller at alle mapper må fylles med avansert AI. Det betyr at dere kan begynne enkelt og utvide uten at hele systemet blir uforståelig.
Slik kan en liten bedrift starte
Begynn med en oppgave som er nyttig, men reverserbar. Et eksempel kan være å sortere innkommende henvendelser i noen få kategorier. Hold mennesket i loopen, og mål resultatet mot dagens arbeidsmåte.
I første versjon trenger dere kanskje bare en inngang, én service, én versjonert prompt, en enkel sikkerhetsregel og en logg. Når dere ser at oppgaven fungerer, kan dere legge til et lite testsett. Først når volum eller risiko tilsier det, bør dere bygge mer avansert routing, agentarbeid og observability.
Artikkelen om AI-orkestrering forklarer hvorfor modellen bare er én del av løsningen. For en mer konkret arbeidsmetode kan dere også se på harness engineering.
Hvis en kodeagent skal vedlikeholde løsningen
Illustrasjonen viser også `.claude/` som et eget prosjektområde. Det er ikke en del av AI-tjenesten som kundene bruker. Det er kontekst for kodeassistenten som skal endre systemet: regler for kodestil, testing, arkitektur og mapper den skal respektere. Når løsningen vokser, gjør slike prosjektregler det enklere å få agenten til å teste før den endrer noe.
Oppsummert
En produksjonsklar AI-løsning er sjelden bare en modell med en prompt. Den trenger arbeidsflyt, henting, routing, sikkerhet, evaluering og innsikt i hva som skjer etter lansering.
De ni lagene er derfor best brukt som en sjekkliste. Ikke bygg alt på én gang. Bruk listen til å se hva som mangler når en demo skal bli en løsning dere faktisk tør å bruke.
Et enkelt neste steg er å velge én eksisterende demo og spørre: Hvilke data leser den, hvem godkjenner svaret, og hvordan oppdager vi feil? Deretter kan dere teste den avgrenset gjennom en sikker AI-pilot på 30 dager.
Når en agent skal jobbe over flere økter, er neste steg å bygge et lite arbeidsmiljø rundt oppgaven. Se Harness Engineering fra grunnen av for kontekst, minne, testing og kontrollerte loops.